阿里是国内唯一把主力大模型全部开源的头部大厂。从 2014 年的 iDST 研究院到 2026 年的 Qwen3.8,十年间通义长成全球第一大开源模型家族。
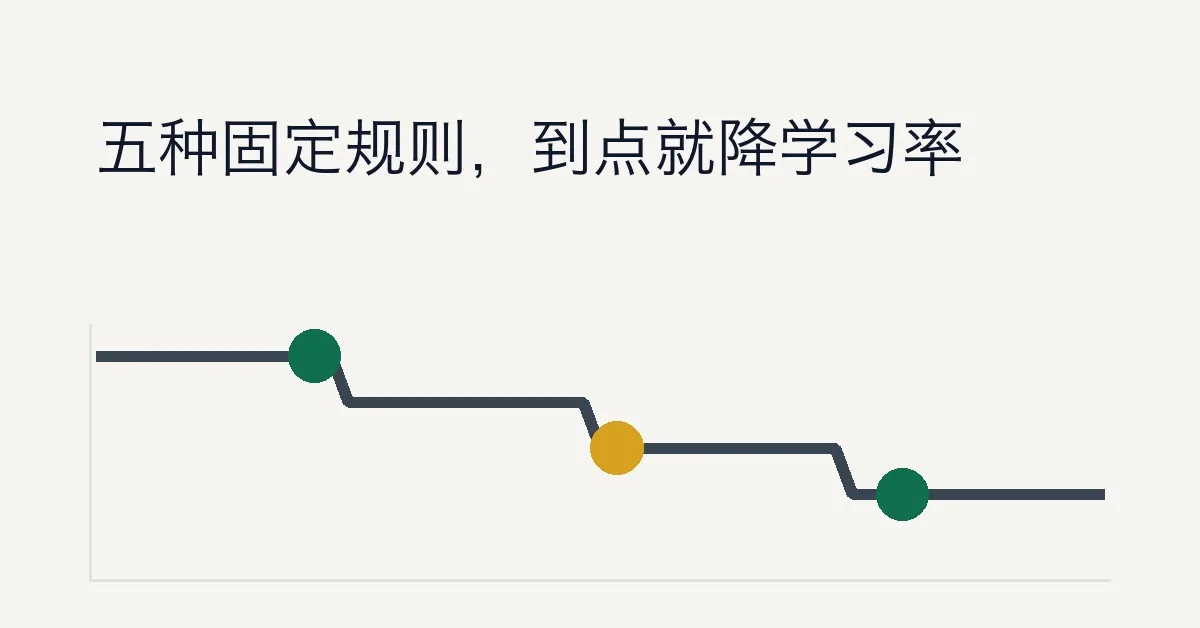
学习率设大了不收敛,设小了训练慢。调度器按预设规则自动调学习率,前期大步快跑,后期小步精调。本文讲清用法,再逐个讲五种固定衰减策略,附参数、代码和场景。
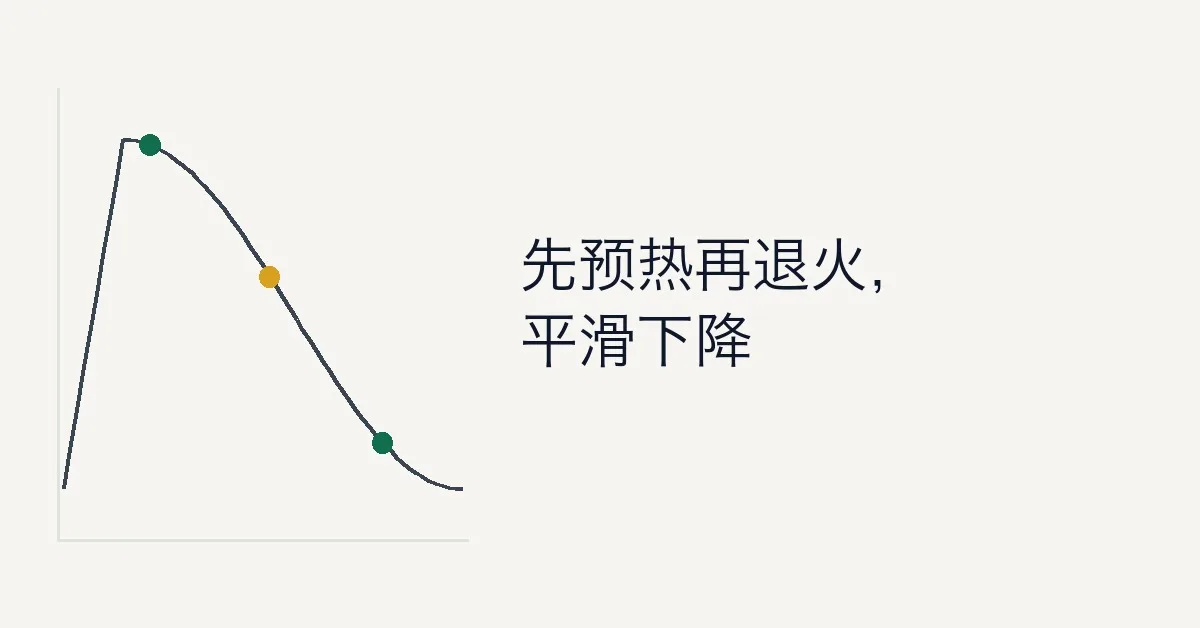
训练开头先小步预热,等梯度稳了再放开步长。本文讲三组灵活调度器:预热工具、余弦退火、组合策略,每族配参数和代码,最后演示 warmup 加余弦衰减的经典组合。
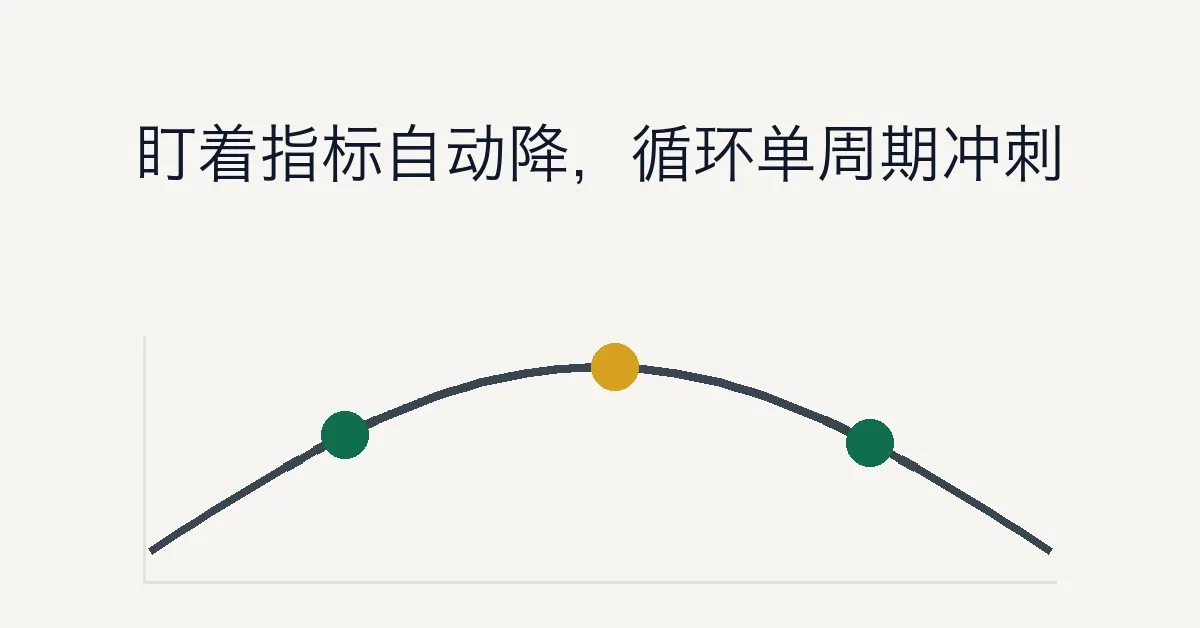
不知道什么时候该降学习率,可以让调度器盯着验证集指标,停滞就自动降。本文讲自适应调度、循环与单周期三类策略,最后给一份按处境选策略的速查表。
逐字独立预测标签,常出现 O 后直接接 I-LOC 这类不合理组合。CRF 用转移矩阵学习标签衔接规则,对整条标签序列统一打分,用维特比找最优序列。
通过 ctypes,讲解动态库编译、类型映射与指针缓冲区,解决 Python 性能瓶颈,掌握 CDLL 加载与签名设置,提升 Python 与 C 协作。
通过 Python/C API 编写扩展,讲解返回值构造、参数解析与模块注册,解决 Python 性能瓶颈,掌握扩展编写与安装技能,提升扩展开发能力。
MiniMax 由闫俊杰 2021 年底创立,从 Glow 情感陪伴 App 到 Talkie 出海,再到海螺视频刷屏,2026 年 1 月港股上市,成长为文本语音音乐图像视频五模态全栈公司。
前微软全球副总裁姜大昕 2023 年在上海创立阶跃星辰,从 Step-1 千亿稠密到 Step 5 六千亿稀疏 MoE,两年半走完通用基座之路,C 端折戟后转身开源与终端。
小米从 2017 年小爱音箱出发,2025 年以 70 亿参数 MiMo-7B 开源一战成名,17 个月走到万亿参数 MiMo-V2.6,用端云协同和汽车反哺基座。

字节不是大模型最早玩家,却用三年把豆包做到日活过亿。从推荐算法到 Seed 团队,从仓促上车到全模态工厂,这是后发者的胜利故事。
从 2023 年幻方量化转型成立深度求索,到 V4 系列 1.6 万亿参数开源,这家不到两百人的小团队用极致工程改写了大模型的成本规则。
科大讯飞 1999 年靠中文语音起家,2014 年前后启动讯飞超脑,2023 年发布星火大模型,在芯片管制下走出全国产算力路线,2026 年开源百万上下文端侧模型 X2.5。
腾讯入局大模型最晚,却把混元悄悄塞进微信、QQ、文档、会议、游戏。从优图到混元 Hy4,这是一家应用为王公司的 AI 打法。
从 2006 年清华 AMiner 学术搜索,到 2026 年 GLM-5.3 旗舰模型,智谱走出了一条学术先行、开源聚拢、再走向产业的产学研之路。
通过 NULL 与 nullptr 对比,讲解 C++ 空指针的由来与区别,解决 NULL 类型不明确,掌握 nullptr 用法,提升空指针安全编码。
从 2018 年发布昇腾芯片到 2026 年 openPangu-2.0 开源,华为用八年时间走完了一条从造芯、攒算力、养盘古到最终开源的全栈自主之路。
月之暗面 2023 年由杨植麟创立,Kimi 靠 20 万字长文本起家,历经 DeepSeek 冲击后回归推理与开源,2026 年开源 2.8 万亿参数 K3,成为全球最大开源模型。
美团从 2016 年无人配送和 2019 年智能调度出发,2023 年收购光年之外,2025 年 9 月开源龙猫 LongCat,2026 年用五万张国产卡训出 1.6 万亿参数 LongCat-2.0。
李彦宏十三年前押注 AI,经历吴恩达离场、被嘲起大早赶晚集,2025 年被 DeepSeek 刺痛后果断开源,从文心一言到文心 5.0 终于端上桌。
商汤 2014 年由汤晓鸥从港中文实验室创立,靠人脸识别成为 AI 四小龙,2023 年转身大模型,2026 年开源原生统一架构 U1,完成从视觉龙头到多模态厂商的二次转身。
昆仑万维 2008 年靠网页游戏起家,海外收入九成,2023 年 4 月发布天工大模型,以视频音乐游戏世界模型三条线和 AI 短剧实现商业化闭环。
通过为特定类型定制模板实现,讲解函数与类模板特化语法,解决通用模板无法适配特殊类型问题,掌握全特化与偏特化区别,提升 C++ 泛型设计能力。
系统讲解 Python logging 模块的级别、格式器、处理器与配置方法,配完整可运行示例,讲清何时用哪个级别,帮读者告别 print 调试。
通过 Jaccard、Hamming、Tanimoto 等度量,讲解二进制向量相似度与距离原理,解决特征比较问题,掌握各度量适用场景,提升向量检索能力。
通过停止条件、等待间隔与异常筛选三个旋钮,讲解 Tenacity 重试库的配置与用法,解决瞬时故障导致任务失败问题,掌握重试策略,提升外部服务调用稳定性。
通过底层存储视角,讲解 Python 列表、字典、元组与集合的实现原理,解决容器选择与性能差异问题,掌握扩容机制与可变性,提升数据结构理解。
通过距离度量与多数投票,讲解 KNN 分类回归的原理与流程,解决惰性学习分类与样本相似匹配问题,掌握 K 值与距离选择,提升机器学习基础算法理解。
通过 type 创建类与元类定制,讲解 metaclass 拦截类创建,解决类行为难以统一定制,掌握 __new__ 与元类应用,提升 Python 编程。
通过图排序与共现权重,讲解 TextRank 与 PageRank 的关系及迭代收敛,解决关键词抽取依赖词频的问题,掌握共现窗口计算,提升关键词抽取能力。
通过在自注意力中引入位置关系,讲解相对位置编码的原理,解决绝对位置编码难以捕捉相对顺序问题,掌握 RPE 与 APE 用法区别,提升对位置建模的理解。
通过 n-gram 匹配与惩罚项,讲解 BLEU 评价生成质量的原理,解决生成质量难以自动评估问题,掌握 BLEU 计算与使用场景,提升文本评测能力。
通过残差网络与占位结构示例,讲解 nn.Identity 恒等映射层的作用与典型用法,解决模型结构复用与条件分支问题,掌握何时需要占位层,提升结构设计细节。
通过 ReLU 与 Dropout,讲解 AlexNet CIFAR10 分类,解决深层网络梯度消失与过拟合,掌握网络构建与训练评估,提升 CNN 实战。
通过 BERT 特征与 CRF 约束,讲解 Bert+CRF 实现 NER,解决标签序列依赖约束,掌握 CRF 接入与训练评估,提升 NER 建模。
通过位域声明与存储布局,讲解结构体按位分配内存节省空间的语法,解决结构体内存浪费问题,掌握位域规则与大小计算,提升 C 结构体内存优化能力。
讲解 getattr、hasattr、setattr 等反射机制的用法与原理,配实例演示动态调用与常见应用,让 Python 代码更灵活。
通过多组数组从右往左逐位对齐,讲解 numpy 广播规则与三类运算,解决不同 shape 数组运算报错问题,掌握形状判定方法,提升数值计算与报错排查能力。
通过 C99 伸缩性数组成员特性,讲解结构体末尾不定长数组的声明与分配规则,解决动态分配问题,掌握 malloc 配合用法,提升结构体内存布局理解。
从位运算的直觉讲起,用完整演示程序拆解按位与或非、移位等常用技巧,讲透性能优势和边界陷阱,辨析常见误区。适合想用位运算提速、优化存储、参加算法竞赛的读者。
通过 n-gram 匹配统计,讲解 Rouge-N 与 Rouge-L 评估,解决生成与参考相似度难衡量,掌握 Rouge 变体与计算,提升文本摘要评测。
讲透四类张量形状操作。reshape 重排布局,transpose 只改步长,view 要求内存连续,squeeze 去掉冗余维,表格对照前后 shape。
讲清 PyTorch 两种张量合并函数。cat 沿已有维度接长,维度数不变,用于残差与通道融合。stack 先插新维度再放入张量,维度加一,用于组批次。
通过五类索引的对比演示,讲解 PyTorch 张量取数方法,解决索引取错数与形状悄悄变化问题,掌握整数、切片、列表、布尔索引用法,提升张量操作准确性。
讲透张量四则运算与矩阵乘法的区别,阿达玛积对应位置相乘,矩阵乘法按行乘列求和,配 in-place 对照表和设备规则,是 PyTorch 计算篇的入门地基。
把七种向量相似度量一次讲透,每种给定义、直觉和代入算好的数。重点区分距离类与相似度类,并用同一对向量列表对照,帮你按在不在乎长度和量纲选型。
把创建张量的接口按从数据造、按规则造、造常量、改类型四组理清,讲清 tensor 与 Tensor 的歧义、未初始化陷阱和类型转换要接返回值,避免上手踩坑。
通过六个常用函数演示,讲解 PyTorch 归约与逐元素运算,解决 dim 参数压错维度问题,掌握输出形状判断方法,为理解 softmax 与交叉熵打基础。
通过 backward 与 grad,讲解 PyTorch Autograd,解决手动求导易错,掌握 requires_grad 与反向传播,提升效率。
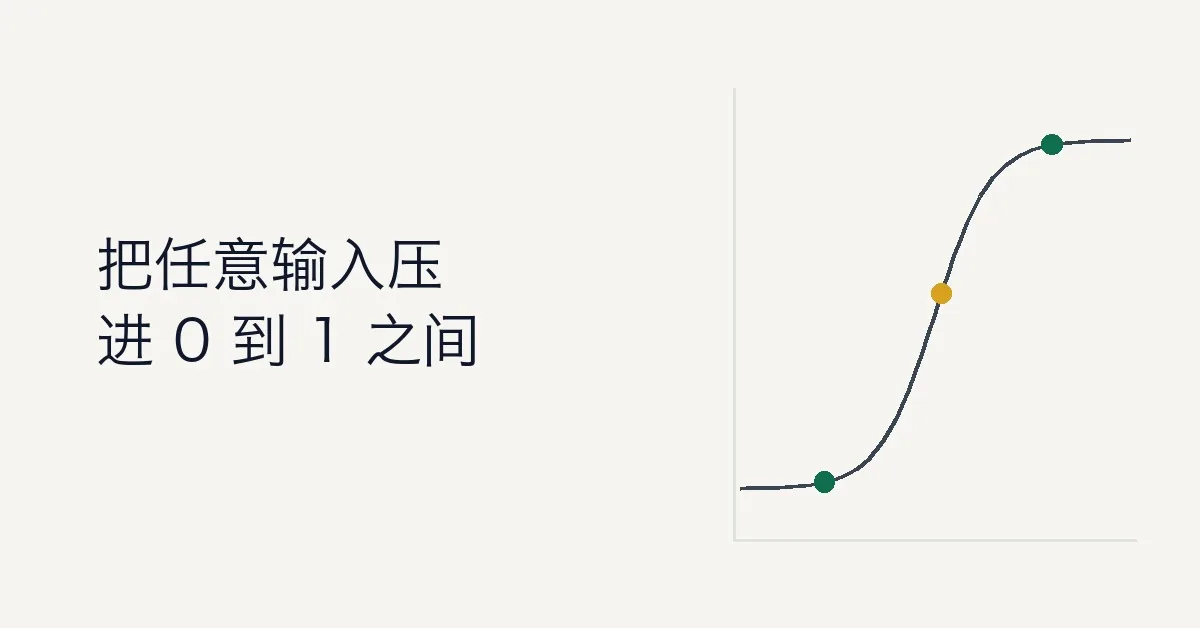
通过公式与图像对比,讲解 Sigmoid 与 LogSigmoid 差异,解决线性模型表达能力不足问题,掌握两者梯度特性与适用场景,提升激活函数选型能力。
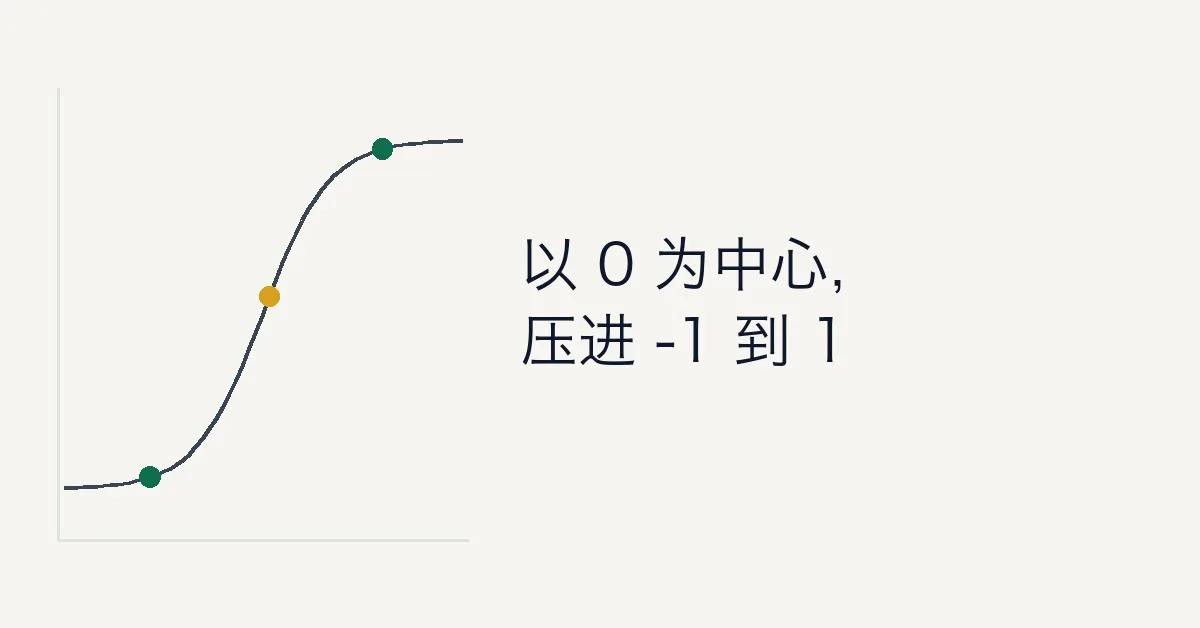
通过双曲正切公式与图像,讲解 Tanh 输出分布与梯度特性,解决 Sigmoid 非零中心收敛慢问题,掌握 Tanh 导数范围与适用场景,提升激活函数理解。
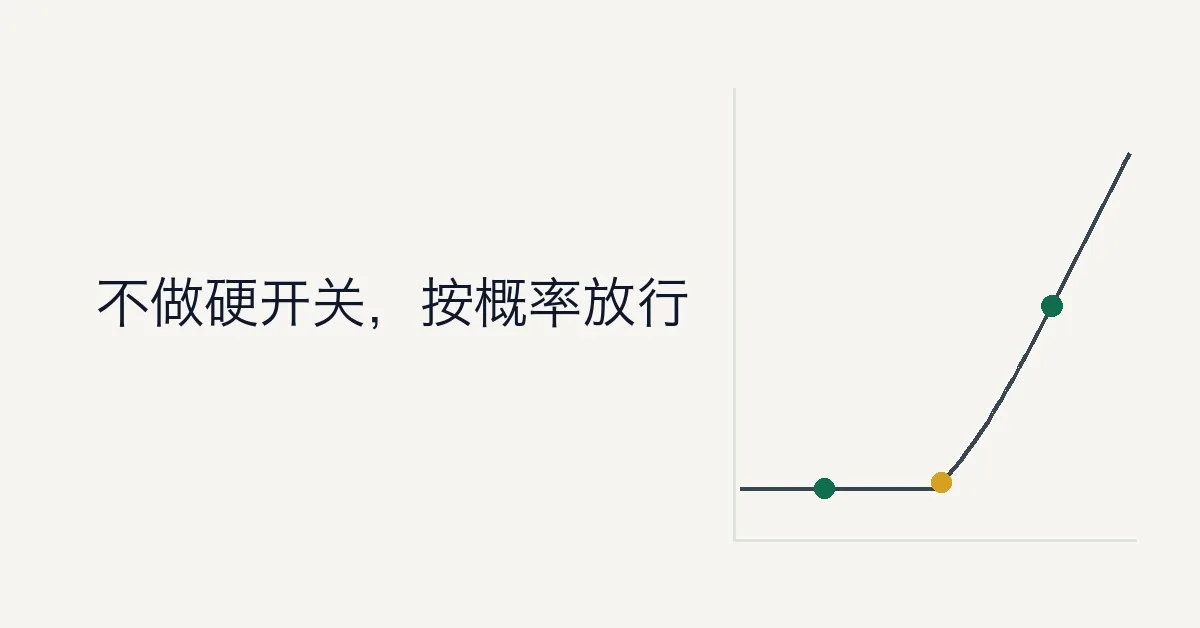
通过正态累计分布软开关设计,讲解 GELU 激活函数原理与实现,解决 ReLU 负值信息被一刀切问题,掌握 GELU 数值计算与代码验证,提升激活函数理解。
讲解 C++ using 的多种用法,类型别名、命名空间与继承中的 using 声明,配示例区分与 typedef 的差异,C++ 基础进阶。
通过 exception_ptr 保存异常对象,讲解 C++ 异常抛出与延迟处理流程,解决异常无法即时处理问题,掌握异常保存与重抛技巧,提升程序健壮性。
通过重载函数调用运算符,讲解函数对象(仿函数)的定义与用法,解决普通函数无法携带状态问题,掌握函数对象与 STL 配合技巧,提升 C++ 泛型编程能力。
通过 DataLoader 参数与示例,讲解采样器与批处理,解决数据加载低效问题,掌握 shuffle 与 num_workers,提升训练数据管道能力。
拆解贪心搜索、束搜索、随机采样三类解码策略,每种配能跟着算一遍的小例子,再落到 HuggingFace 参数组合。读完能根据任务决定生成时该开哪个开关。
通过链式法则反向求梯度,讲解误差反向传播更新网络参数的过程,解决多层网络参数梯度求解问题,掌握前向传播与权重更新,提升神经网络训练理解。
讲解变长文本批量处理的 pad_sequence 用法,含 padding 位置与 mask 处理示例,解决 batch 训练中的长度对齐问题。
从初值偏大爆炸、偏小消失讲起,推导方差传播和前后向折中,用 784 进 256 出的具体算例算一遍高斯与均匀两种取值,最后落到 PyTorch 接口。
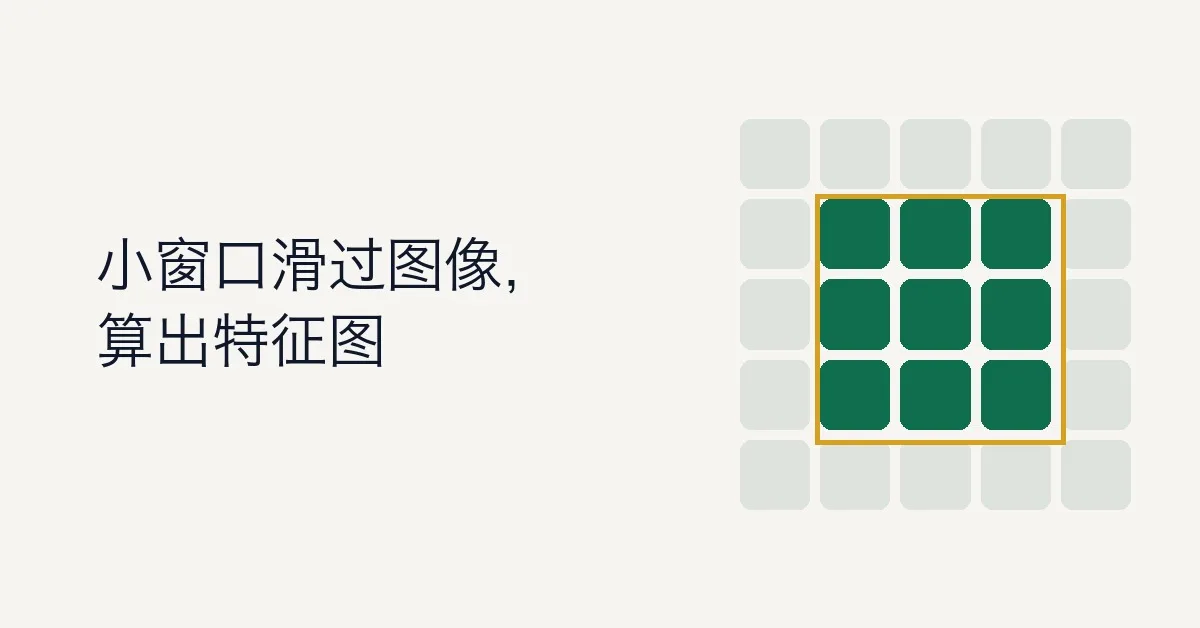
通过卷积核滑动与点积运算,讲解卷积提取特征与 Padding、步长作用,解决全连接处理图像参数爆炸问题,掌握卷积计算与特征图生成,提升 CNN 基础理解。
通过最大池化与平均池化,讲解池化降采样与特征选择的作用,解决特征图尺寸大、计算量高与过拟合问题,掌握池化窗口与计算规则,提升 CNN 结构设计能力。
通过概率分布差异度量公式,讲解 KL 散度衡量信息损失的原理,解决分布间差异难以量化问题,掌握 KL 性质与计算方法,提升生成模型与知识蒸馏理解。
讲清中文 NER 逐字打标签的三套体系,从最省的 BIO 到带首尾单字标记的 BIOES,配同一句中文的标注对照和标签数取舍,读完能独立给句子打标签。
通过限制梯度范数,讲解梯度裁剪防止梯度爆炸的原理与实现,解决训练不稳定与损失发散问题,掌握裁剪方法与阈值设置,提升深度神经网络训练稳定性。
通过 Transformer 编码器架构,讲解 BERT 预训练目标与 MLM、NSP 的作用,解决下游任务适配问题,掌握微调用法,提升预训练模型理解。
通过微调预训练 BERT,讲解中文酒店评论分类完整流程,解决情感分类准确率提升问题,掌握数据预处理与微调评估方法,提升 NLP 分类落地能力。
通过从零训练小尺寸 Llama,讲解直接训练生成对联的词表构建与训练流程,解决对联生成对称与韵律问题,掌握数据处理与模型训练,提升生成模型实战能力。
通过段级递归与相对位置编码,讲解 Transformer-XL 突破长度限制,解决长文本受限问题,掌握长依赖建模与位置编码设计,提升长序列建模能力。
讲清 ALBERT 靠嵌入分解和跨层共享把 BERT 压到九分之一参数还不掉点,配合 SOP 与 n-gram 掩码,是理解模型压缩与预训练设计的入门佳作。
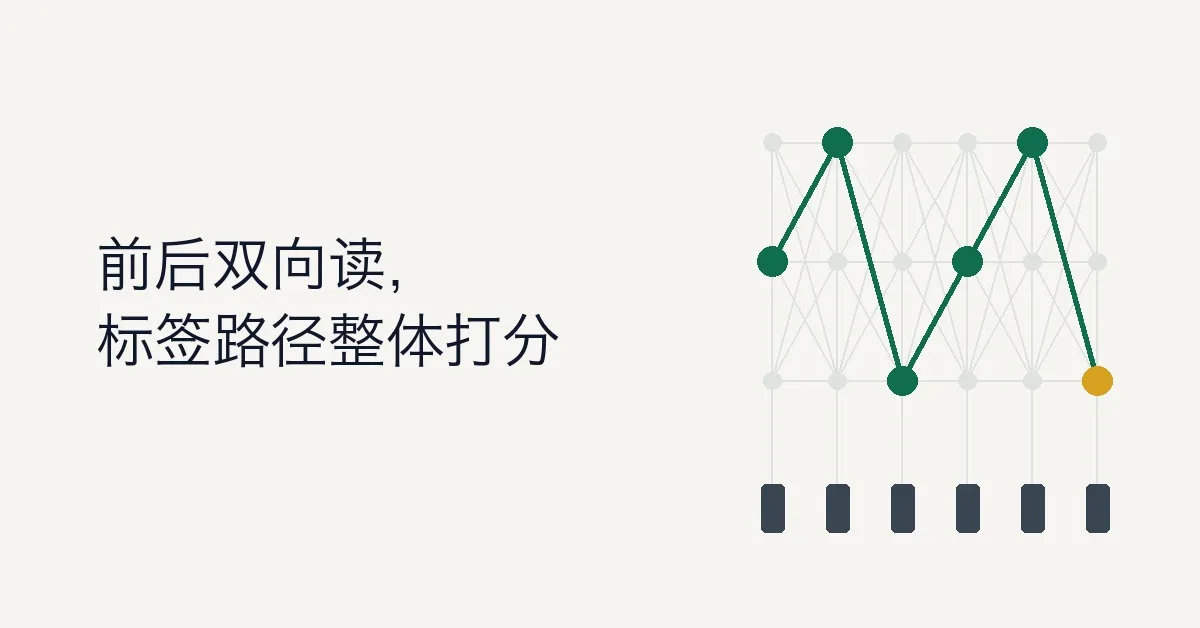
做命名实体识别(NER)的时候,BiLSTM + CRF 是绕不开的经典组合。跑通一个模型不难,但很多人卡在同一个地方:CRF 这一层到底在做什么,损失函数为什么长那个样子,分母里所有路径的分数又是怎么算出来的。这一节我们就把这些问题一次性讲清楚,原理通了,看代码自然就顺了。 1. 序列预测 BiLSTM 负责接收输入,理解每个 token,然后输出每个 token 属于各个标签的分数。 判断是否为实体,要依赖它的上下文。拿他在清华大学读书这句话来说,看到清华前面的在,才知道后面多半是机构名。看到后面的读书,也能跟前面的机构名衔接起来。单向的 LSTM 只能看到左边的信息,右边的信息就丢了。B...
通过动量对梯度进行优化,讲解 SGD 动量法加速收敛的原理,解决梯度为零时参数无法更新问题,掌握动量参数与更新公式,提升对优化器的理解。
通过累积梯度机制对比,讲解 AdaGrad 与 RMSProp 优化器原理,解决统一学习率不适配各参数问题,掌握公式推导与适用场景,提升优化器选型能力。
通过一阶二阶动量与偏差修正,讲解 Adam 融合动量与 RMSProp 机制,解决梯度震荡与学习率难调,掌握 Adam 参数与使用建议,提升优化器选型。
通过对比 L2 正则化,讲解 weight decay 在优化器中衰减权重的机制,解决模型过拟合与权重过大问题,掌握两者区别与设置方法,提升正则化调参能力。
通过生成器-判别器的替换词检测,讲解 ELECTRA 高效预训练机制,解决掩码预训练效率低问题,掌握 RTD 判别式训练原理,提升对高效预训练模型的理解。
讲清 R-CNN 两阶段检测流程,从候选框、提特征到 SVM 分类与边框回归,配完整尺寸算例,是读懂 Faster R-CNN 的地基。
从方差和特征值讲透 PCA 找主方向的原理,手算一个 5 行 2 列矩阵的降维重建,再落到彩色图三通道压缩的可跑代码,讲清这种有损压缩丢了什么。
讲清 LSA 把文档做成 TF-IDF 矩阵,用 SVD 拆出文档到主题、主题到词两个矩阵,靠手算小矩阵看懂奇异值截断和聚类,是文本语义聚类的经典方法。
围绕一棵八节点示例树,把先中后递归、带标记栈的非递归和队列层序都在同一棵树上手算走通,表格对照四种顺序的输出与用途,讲透访问根的时机如何决定遍历次序。
先厘清图、有向无向边、完全图和权等基本概念,再用四顶点小图把邻接矩阵和邻接表建出来,对比二者在空间、查边、找邻接点和图密疏上的取舍,讲清稀疏图为何选表。
通过贪心选取最短路径顶点,讲解 Dijkstra 单源最短路径算法过程,解决有向图最短路径求解问题,掌握数组实现与更新规则,提升图算法应用能力。
通过插点法三重循环,讲解 Floyd 计算所有顶点对最短路径的原理,解决多源最短路径与负权图问题,掌握动态规划递推与实现,提升图算法能力。
通过逐个顶点选取最小边,讲解 Prim 算法构建最小生成树的贪心过程,解决连通图最小生成树求解问题,掌握邻接矩阵实现与复杂度,提升图算法应用能力。
通过按边权排序与判环合并,讲解 Kruskal 算法构建最小生成树的贪心过程,解决最小生成树求解问题,掌握并查集判环与边选取,提升图算法应用能力。
讲清二叉搜索树退化链表让查找掉到 O(n),用插入 3、1、2 演示 AVL 识别失衡并按 LL、LR、RR、RL 旋转,把增删查稳定回 O(log n)。
通过变长编码与权值建树,讲解霍夫曼树构建与压缩解码全流程,解决定长编码空间浪费问题,掌握前缀码与最短总位数原理,提升无损数据压缩与应用边界理解。
通过组合特征矩阵分解,讲解因子分解机建模二阶特征交叉的原理,解决高维稀疏特征组合爆炸问题,掌握内积形式与复杂度优化,提升推荐模型建模能力。
通过 PaddleNLP 预训练模型微调,讲解 ERNIE 中文情感分类,解决情感分类准确率,掌握微调评估与模型预测,提升中文 NLP 任务落地能力。
通过随机、按范数与全局三类剪枝接口,讲解模型剪枝将弱权重置零的原理,解决模型体积大、推理慢问题,掌握结构化与非结构化剪枝区别,提升模型压缩部署优化能力。
通过消融实验重选预训练配方,讲解 RoBERTa 去 NSP、动态掩码与大数据量改进,解决预训练配方非最优问题,掌握预训练设置的影响,提升模型预训练理解。
讲清 PEGASUS 为何用挖空位句拼伪摘要当预训练任务,六种挑句策略如何比选,最终选 Ind-Orig 和三成比例,MLM 被弃用,抓住这套设计思想。
从 BERT 的 MASK 缺陷讲起,拆解排列语言模型和双流自注意力两套机制,再走一遍预训练与微调流程,理解不靠 MASK 也能双向建模的完整思路。
拆解基于用户和基于物品两条协同过滤路线,用四用户五物品评分表亲手算一遍缺失评分,配完整 Python 实现,并辨析方法选择与冷启动边界。
通过难易样本权重调节,讲解 focal loss 解决类别不平衡的原理,解决少数类样本学习不足问题,掌握调制因子与超参设置,提升不平衡分类建模能力。
通过拆解训练各环节显存占用,讲解 CUDA 内存与前向反向开销来源,解决显存不足难以定位问题,掌握显存优化方向,提升 PyTorch 训练资源管理能力。
通过稀疏化注意力机制,讲解 Longformer 线性复杂度设计,解决长文本计算瓶颈,掌握滑动窗口与全局注意力配置,提升长文档建模能力。
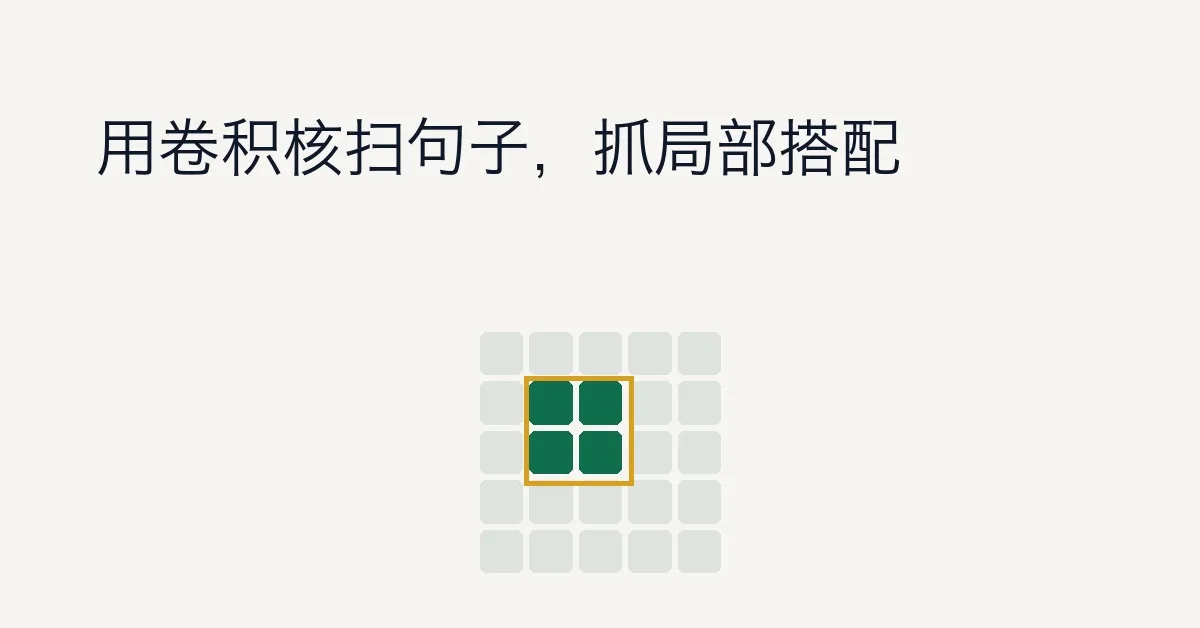
从 Conv1d 在文本上的张量形状讲起,理清 padding、dilation 与输出长度公式,再拼出经典 TextCNN,代码可跑通,适合入门文本卷积。
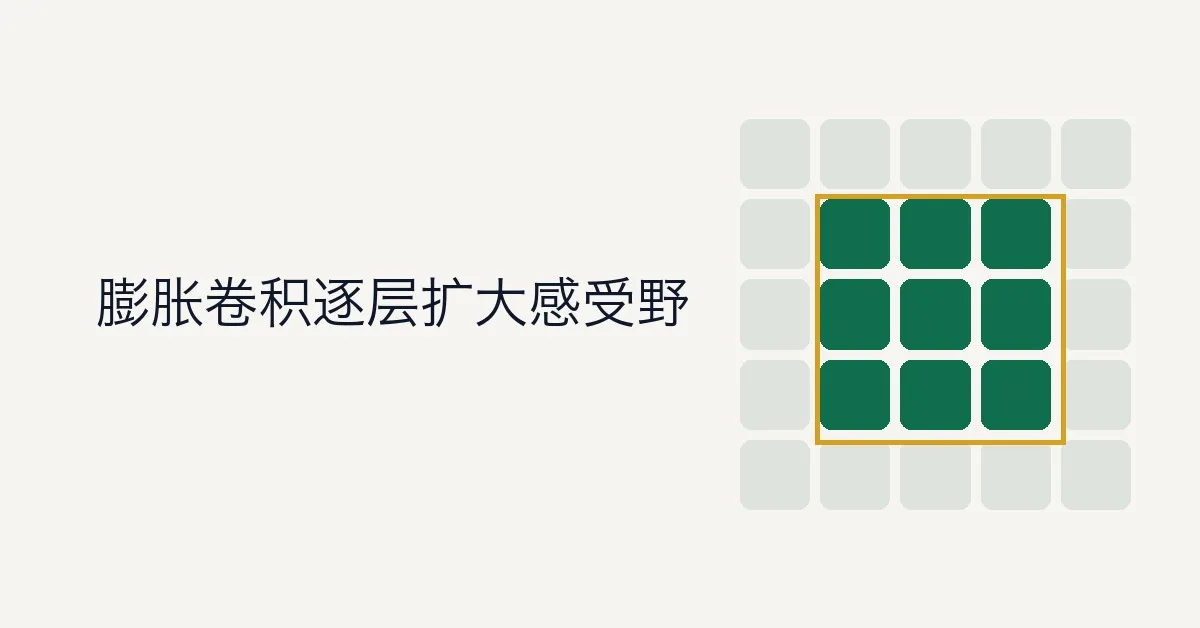
通过因果卷积与扩张卷积组合,讲解时序卷积网络处理序列数据的原理,解决 RNN 难以并行与长依赖差的问题,掌握感受野与扩张率设计,提升时间序列网络建模能力。
通过在分类与检测中替换全连接层,讲解卷积层作为输出层的原理与实现,解决全连接参数多、输入尺寸固定问题,掌握 1x1 卷积替代技巧,提升网络结构设计能力。
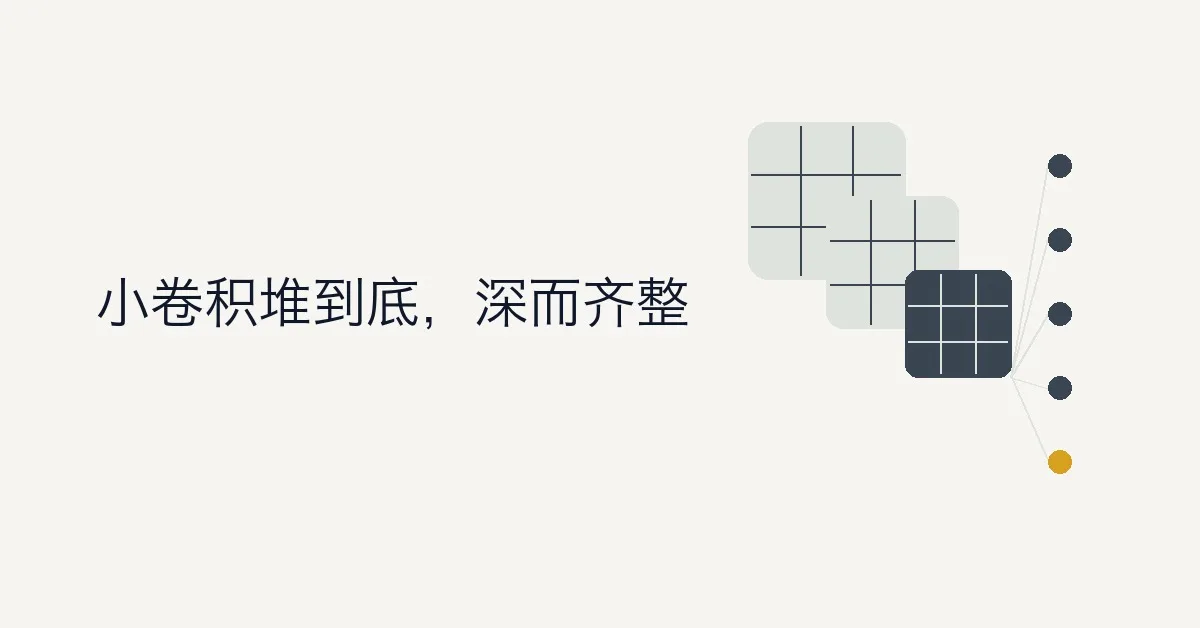
通过小卷积核堆叠加深网络,讲解 VGG 架构与图像分类实现,解决大卷积核参数多、表达弱问题,掌握 VGG 变体与训练评估,提升 CNN 网络结构设计能力。
通过红黑树与就绪链表,讲解 epoll 事件驱动多路复用,解决 select 描述符限制与效率低问题,掌握 epoll 三函数使用,提升高并发网络编程能力。
通过 Span 掩码与边界目标,讲解 SpanBERT 增强片段表示,解决 BERT 单 Token 掩码不足,掌握 SBO 目标,提升预训练模型理解。
通过语言模型概率计算,讲解困惑度衡量预测能力的原理与公式,解决语言模型质量难以量化评估问题,掌握困惑度计算与解读方法,提升 NLP 模型评估能力。
通过情感知识增强掩码策略,讲解 SKEP 预训练模型实现观点抽取的方法,解决情感要素识别问题,掌握数据处理与模型微调评估,提升情感分析实战能力。
通过计算类别均值向量,讲解基于类别均值的分类方法原理与实现,解决简单场景下快速分类问题,掌握均值计算与最近邻判定,提升基础分类方法理解。
通过逐行分析源码,讲解 Bert 多头注意力的 QKV 拆分与缩放点积,解决自注意力计算原理理解难问题,掌握 softmax 与输出投影,提升源码阅读能力。
用开源中文 Pegasus 权重在 LCSTS 上继续微调,配数据构造、训练评估、现场生成的完整链路,点出词表替换等实操坑,适合想复现中文摘要的人。
通过生成器与判别器对抗训练,讲解基于 GAN 在 STL10 上生成图像的全流程,解决真实图像生成问题,掌握数据加载与对抗训练技巧,提升生成模型实战能力。
通过 Softmax 与多分类损失推导,讲解 XGBoost 由二分类扩展多分类的原理,解决多类别分类建模,掌握目标函数与概率输出,提升梯度提升树应用。
通过指针存储地址与类型作用,讲解指针声明、多级指针与内存访问语法,解决直接操作内存与传址问题,掌握指针类型与取址解引用,提升 C 语言基础功底。
通过内存布局与完整示例,讲解 C 字符串与指针的配合方式,解决字符串常量与字符数组的常见陷阱问题,掌握 \0 结尾与字符数组指针操作,提升字符串处理准确性。
从内存视角讲清指针与数组名的关系,下标访问为何高效,数组名何时退化为首元素指针,澄清取地址误区,示例代码完整可编译,帮初学者建立正确认知。
通过函数名即指针与间接调用,讲解函数指针的定义、赋值与回调用法,解决运行时动态选择函数的问题,掌握函数指针与回调机制,提升 C 语言高级编程能力。
通过上采样与可学习权重,讲解转置卷积放大特征图的原理,解决特征图尺寸恢复与上采样问题,掌握转置卷积与反卷积的区别,提升生成模型结构理解。
通过随机数种子与分布映射,讲解 C/C++ 生成均匀与正态随机数,解决伪随机数不可控与分布不均,掌握 random_device 与生成器,提升程序模拟。
通过哈希函数将相似点映射到同一桶,讲解局部敏感哈希近似最近邻检索的原理,解决高维数据线性搜索耗时问题,掌握哈希桶结构与检索流程,提升高维向量检索效率。
通过水平垂直梯度计算,讲解 Sobel 算子检测图像边缘的原理与 API 用法,解决图像边缘信息难以提取问题,掌握梯度计算与边缘检测流程,提升图像处理能力。
通过判序与转换两段可运行代码,讲解 C/C++ 大小端字节序区别与网络字节序由来,解决跨机通信数据解析错乱问题,掌握字节序判断与转换,提升底层网络编程能力。
通过嵌入 Python 与 C API,讲解 C++ 调用 Python 对象,解决跨语言集成,掌握 Py_Initialize 与调用,提升混合编程。
通过 ROC 曲线与真正例率假正例率,讲解 AUC 评价二分类的原理,解决阈值变化下评估失真问题,掌握 ROC 与 AUC 计算,提升二分类模型评估能力。
通过标准化每层输入分布,讲解批量归一化解决内部协变量偏移的原理,解决深层网络训练不稳定、收敛慢问题,掌握 BN 训练与推理用法,提升模型训练稳定性。
通过样本内统计均值方差,讲解层归一化与批量归一化区别,解决 RNN、Transformer 分布漂移问题,掌握 LN 计算与适用场景,提升模型训练稳定性。
通过 CUDA 配置,讲解 GPU 并行计算与 Hello World 流程,解决 CPU 算力受限,掌握核函数与 nvcc 编译,提升 GPU 编程。
通过 PyTorch 手写递归网络,讲解 RNN/GRU/LSTM 评论分类流程,解决情感分类建模问题,掌握词表构建与训练评估,提升深度学习实战能力。
通过 AWQ 感知量化算法,讲解 AutoAWQ 对模型量化压缩的方法,解决大模型显存占用高、推理慢问题,掌握量化配置与精度评估,提升模型部署优化能力。
通过低秩矩阵注入,讲解 LoRA 高效微调分类任务的方法,解决全量微调资源消耗大的问题,掌握 LoRA 配置与训练评估,提升大模型高效微调能力。
通过全量微调 Qwen2.5-0.5B,讲解指令模型适配分类任务完整流程,解决输出不可控与准确率低问题,掌握数据构造与训练评估方法,提升大模型微调落地能力。
通过中文 GPT2 预训练模型微调,讲解生成文本摘要的数据处理与训练流程,解决摘要生成连贯性差问题,掌握数据构造与生成评估,提升文本生成实战能力。
通过生成器判别器对抗训练,讲解 GAN 在 CIFAR10 生成图像的全流程,解决真实图像生成问题,掌握对抗训练与评估方法,提升生成模型实战能力。
通过文本图像共享嵌入空间,讲解基于语义的图像检索完整流程,解决跨模态检索匹配问题,掌握嵌入计算与相似度检索方法,提升多模态应用开发能力。
通过编码器映射分布与解码器重建,讲解变分自编码器的原理与重参数化技巧,解决隐空间不连续与难生成新样本问题,掌握 ELBO 损失与采样方法,提升生成模型理解。
通过给每个位置分配唯一向量,讲解绝对位置编码注入顺序信息原理,解决 Transformer 无法感知词序问题,掌握位置向量相加与正弦编码,提升位置建模理解。
通过 GRU 编码解码与注意力机制,讲解 Seq2Seq 生成对联方法,解决序列到序列文本生成问题,掌握注意力计算与模型训练,提升生成式 NLP 实战能力。
通过微调多语言预训练模型,讲解 mT5 实现中英翻译的数据处理与训练流程,解决中英翻译流畅度与准确性差问题,掌握微调评估与推理方法,提升机器翻译落地能力。
通过 BiLSTM 编码与 CRF 解码组合,讲解中文 NER 数据处理到训练预测全流程,解决实体识别问题,掌握模型搭建与评估方法,提升 NER 实战能力。
通过理解解释器线程执行机制,讲解 GIL 对多线程的影响与场景,解决多线程无法并行执行字节码问题,掌握 IO 密集处理方法,提升 Python 并发能力。

 冀公网安备13050302001966号