
做命名实体识别(NER)的时候,BiLSTM + CRF 是绕不开的经典组合。跑通一个模型不难,但很多人卡在同一个地方:CRF 这一层到底在做什么,损失函数为什么长那个样子,分母里所有路径的分数又是怎么算出来的。这一节我们就把这些问题一次性讲清楚,原理通了,看代码自然就顺了。
1. 序列预测
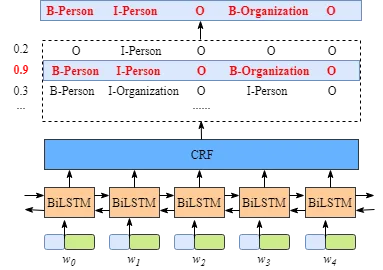
BiLSTM 负责接收输入,理解每个 token,然后输出每个 token 属于各个标签的分数。
判断是否为实体,要依赖它的上下文。拿他在清华大学读书这句话来说,看到清华前面的在,才知道后面多半是机构名。看到后面的读书,也能跟前面的机构名衔接起来。单向的 LSTM 只能看到左边的信息,右边的信息就丢了。BiLSTM 两个方向各看一遍,左右信息都拿得到,判断更准。
光有 BiLSTM 会存在一些问题。BiLSTM 对每个字是独立打分的,它不知道前一个字被标成了什么,所以逐字选分数最大的标签,拼出来的序列经常不符合规则。
举个例子。王晓明在清华大学读书这句话,正确标签是 B-PER、I-PER、I-PER、O、B-ORG、I-ORG、I-ORG、I-ORG、O。王晓明是一段连续的人名,清华大学是一段连续的机构名。如果每个字独立选分数最大的标签,模型不知道前一个字是什么,就可能出现明后面的字被标成 I-LOC,或者句首直接出现 I-ORG。这类错误单独看每个字都有道理,拼成整句却不像话。
CRF 就是来解决这个问题的。它额外学一套标签之间的转移规则,把逐字打分的局部最优,变成整条序列的全局最优。
先看一个实际预测的例子:
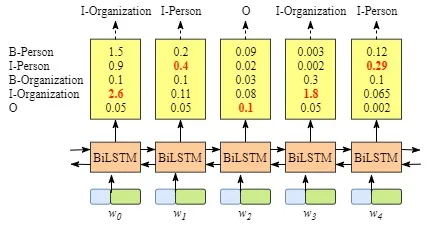
模型实际输出的预测标签序列有很多种。拿 4 个字的句子举例,假设标签只有 5 种(B-PER、I-PER、B-ORG、I-ORG、O),每个字都可以是这 5 种里的任意一种,那么一共就是 5 的 4 次方,625 种序列。下表列了其中几种:
转移分数来自 CRF 的转移矩阵。矩阵的行是前一个标签,列是后一个标签,格子里的值就是从行标签跳到列标签的分数。比如句首不能是 I-PER,O 后面不能直接跟 I-LOC,I-PER 后面不能突然变成 I-ORG,这些约束就体现在转移矩阵里。
用 BIO 标签体系,通常识别三类实体:人名、机构名、地名,加一个表示无关内容的 O,一共 7 种标签:
- 人名:B-PER、I-PER
- 机构名:B-ORG、I-ORG
- 地名:B-LOC、I-LOC
- 其他:O
7 种标签,加上 START、END 两个特殊标记,拼成一张 9 乘 9 的转移矩阵:
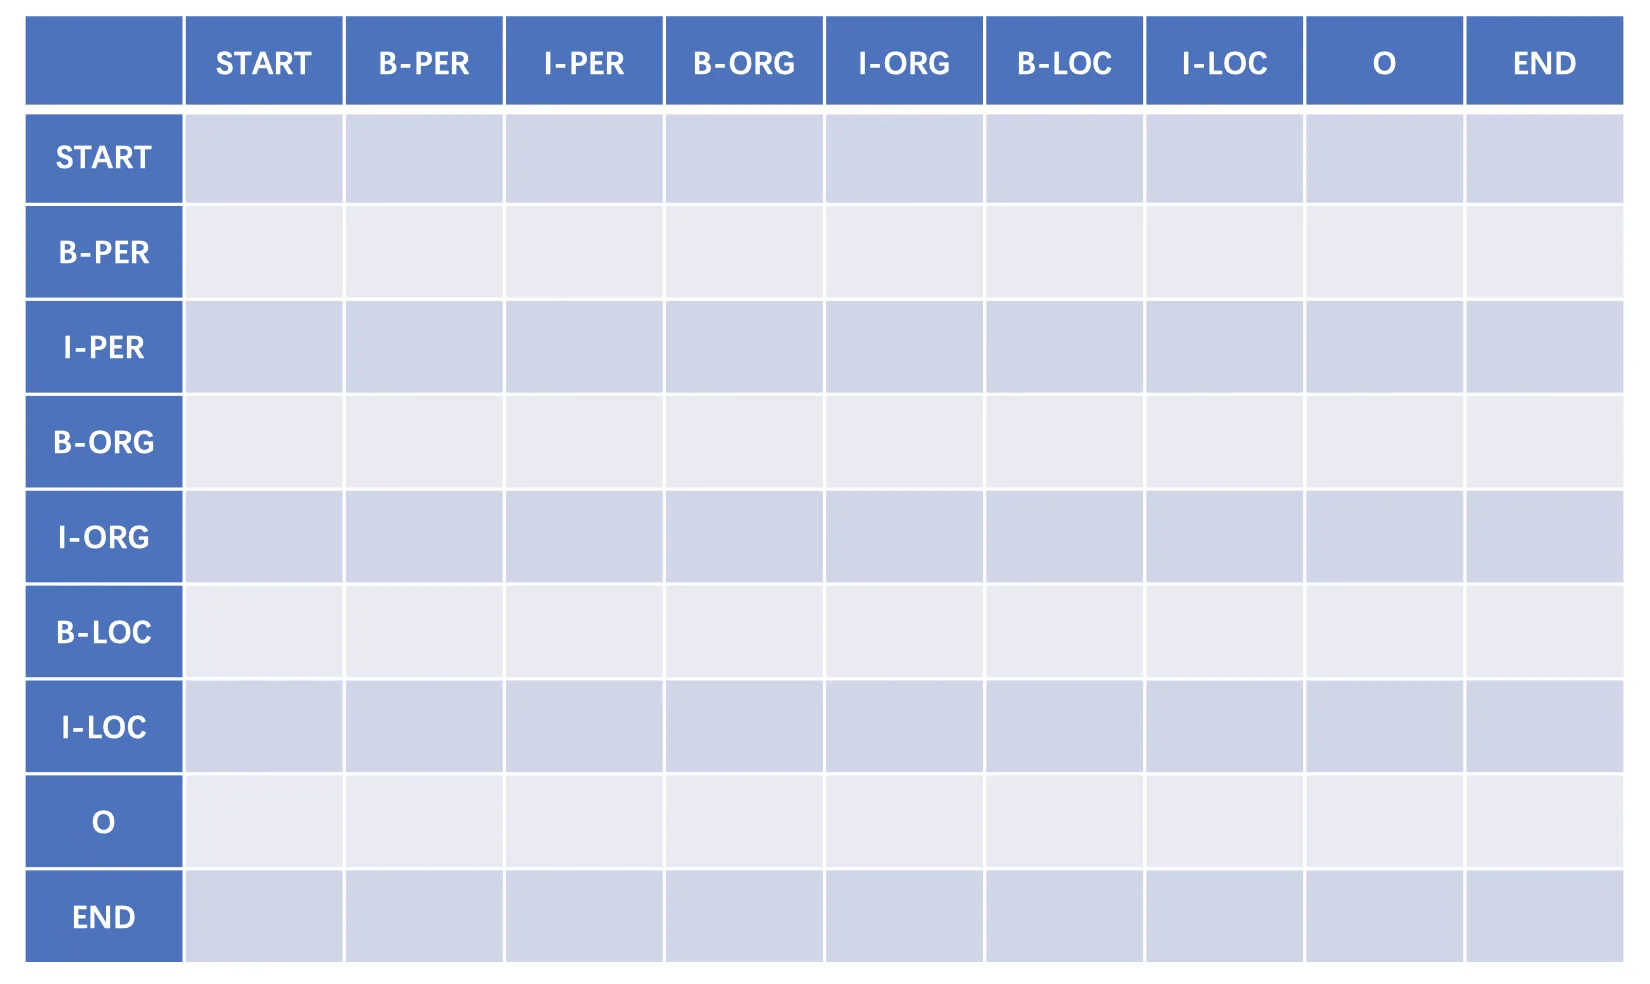
START 和 END 用来表示序列的起点和终点,比如 START 到 B-PER 的分数,表示第一个字是 B-PER 有多合理。初始时这些值可以随便设,训练过程中会被不断调整,最终学出来的值,就是标签之间的合法规则。
一条序列的分数,等于这条序列上每个字的发射分数之和,加上相邻标签之间的转移分数之和。拿 3 个字的 B-PER、I-PER、O 这条序列举例。先从发射矩阵里,把第一个字对应 B-PER 的分数、第二个字对应 I-PER 的分数、第三个字对应 O 的分数取出来,三个加一起。再把 START 到 B-PER、B-PER 到 I-PER、I-PER 到 O 这三段转移分数取出来,也加一起。两部分相加,就是这条序列的总分。最后把总分换算成 \(e^{totalscore}\),就得到一个类似概率的数值,方便不同序列之间比较和归一化。
2. 损失函数
每一条候选序列的分数都会算了,接下来要做的,就是提高正确序列的分数,压低其他序列的分数。衡量这个差距的,就是损失函数。模型通过不断降低损失,找到正确的输出序列。
损失函数如下:
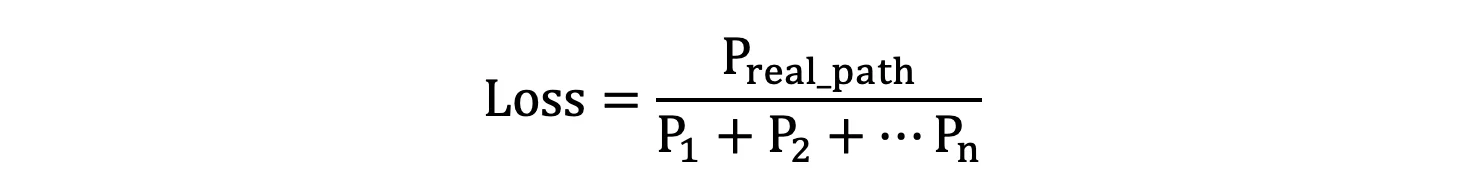
公式里的分子 \(P_{real_path}\),是训练样本真实标签序列的分数。分母是所有可能序列的分数总和。模型学得越好,真实序列的分数占比越高,这个比值越接近 1。训练的目标,就是让正确序列的分数尽量高,其他序列的分数尽量低。
注意,这里的分数指的就是上一节算的序列总分,由发射分数和转移分数组成。所以反向传播时,梯度会同时流到 BiLSTM 的参数和 CRF 的参数,两套参数在损失函数的引导下一起被优化。
分子只有一条真实序列,算起来没什么压力。分母是所有可能序列的分数总和,序列一长,路径就是指数级,一条条枚举根本算不完,训练会非常慢。原作者用了两个技巧加速:一是尽量用矩阵运算,矩阵运算的效率远高于逐个计算,二是用动态规划的思想,把重复计算的结果缓存下来复用。
3. 公式推导
3.1 转成对数损失
损失函数的公式写起来简单,但直接按它落地,效率很低。分母要枚举所有路径,路径是指数级的。所以要对公式做推导,把它变成能高效计算的形式,核心就两条:矩阵运算加动态规划。
先把损失函数转成对数形式:
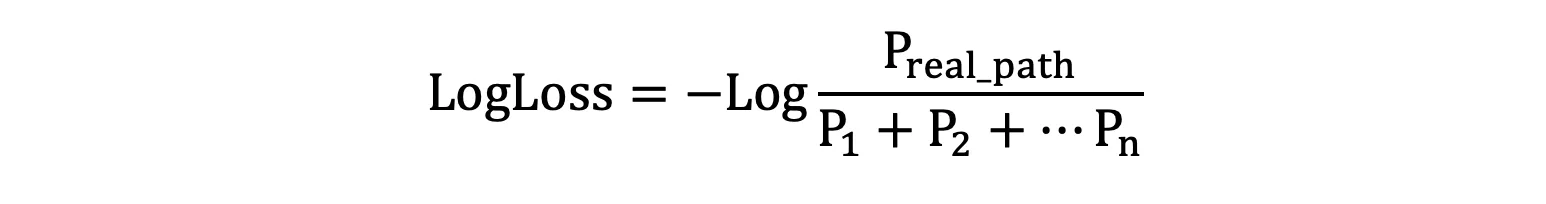
原来的损失希望越大越好,取对数后再在前面加一个负号,就变成了求最小值的问题,也就是找到让这个损失最小的模型参数。继续展开:
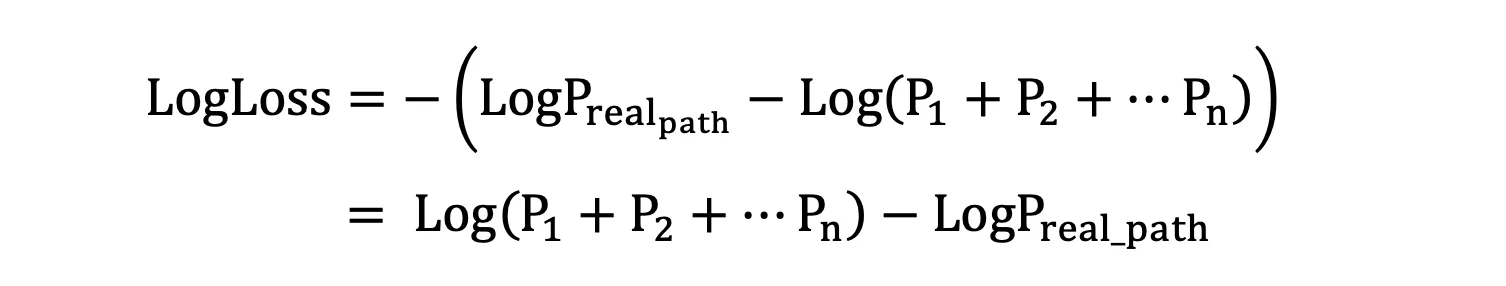
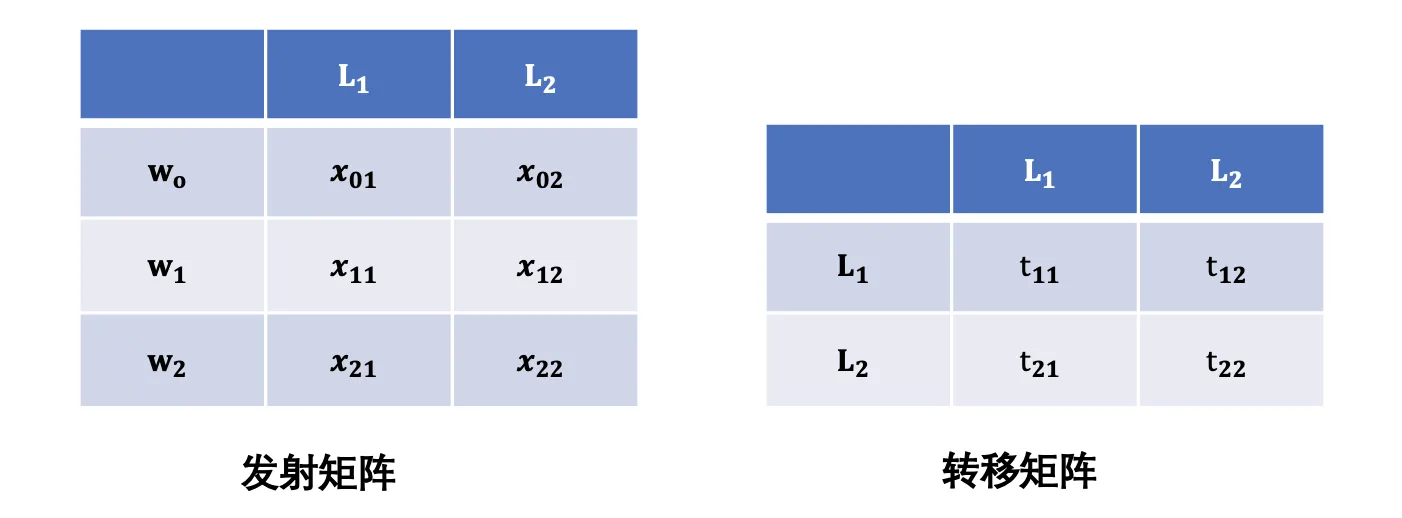
展开之后有两项。第二项是真实序列的分数,一条序列直接算就行。关键在第一项,所有序列分数的对数和。原作者给了一个很直观的例子:输入 3 个字 \(w_0 w_1 w_2\),标签只有 2 个 \(L_1 L_2\),发射矩阵和转移矩阵如下:
3.2 前向算法递推
要算的是 \(log(P_1+P_2…+P_n)\),也就是所有路径分数的对数和。直接枚举路径算不完,前向算法的思路是:从第一个字开始,逐个往后递推,每一步只保留到当前字为止的累计分数,走完整个句子,总分自然就出来了。先引入两个辅助变量:obs 表示当前这个字的发射分数,pre 表示上一个字累计下来的分数。
第一步,处理 w0。第一个字没有转移分数可加,pre 为空,obs 就是 w0 在两个标签上的发射分数 \(x_{01},x_{02}\)。
第二步,从 w0 到 w1。pre 变成 \(x_{01},x_{02}\),obs 是 \(x_{11},x_{12}\)。为了让计算能用上矩阵运算,需要把 pre 和 obs 都扩展成矩阵:pre 先转置,再横向广播一个维度,obs 直接纵向广播一个维度。扩展之后长这样:
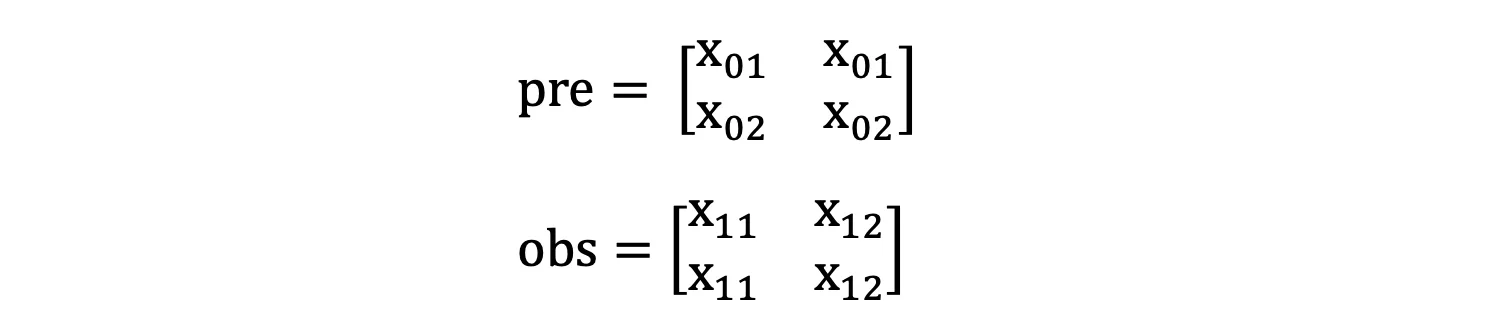
然后按 obs 加 pre 加 transition 逐元素相加,就得到分数矩阵:
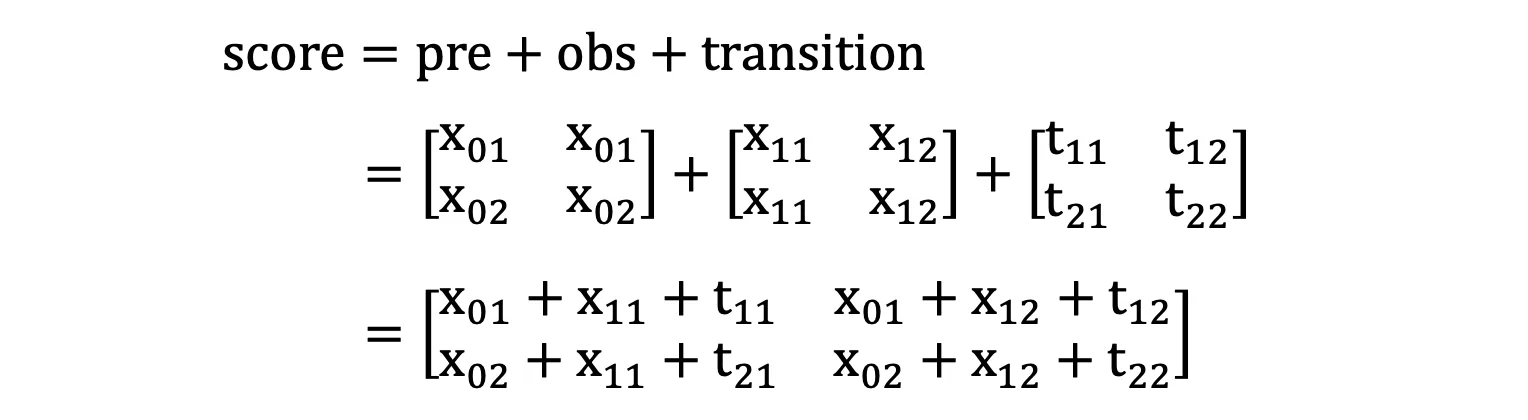
这个矩阵里的 4 个值,正好对应 w0 到 w1 的 4 条路径的分数。对这 4 个值做 log_sum_exp,得到这一步的对数损失:
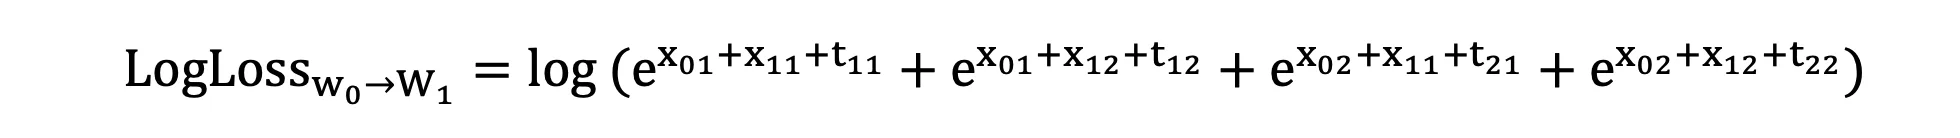
第三步,从 w1 到 w2。pre 换成上一步累加的结果:
pre = [ \(log(e^{x_{01}+x_{11}+t_{11}} + e^{x_{02}+x_{11}+t_{21}})\),\(log(e^{x_{01}+x_{12}+t_{12}} + e^{x_{02}+x_{12}+t_{22}})\) ]
obs 是 w2 的发射分数 \(x_{21},x_{22}\)。还是和第二步一样,把 pre、obs 广播扩展:
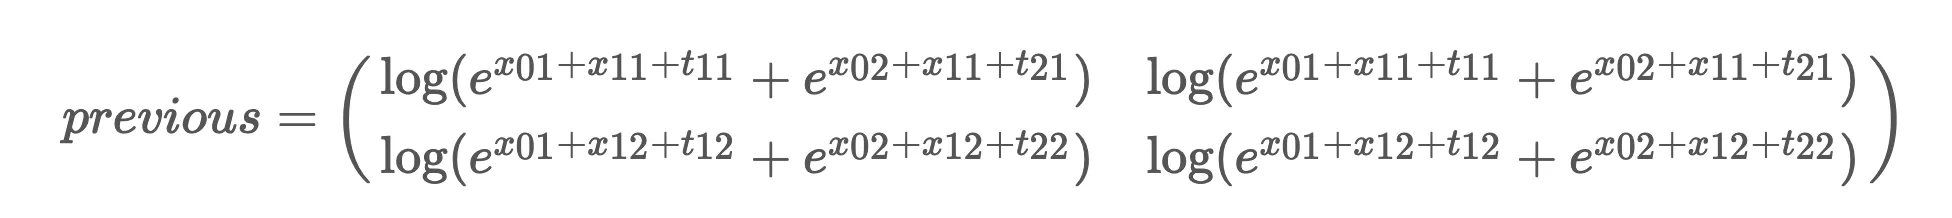
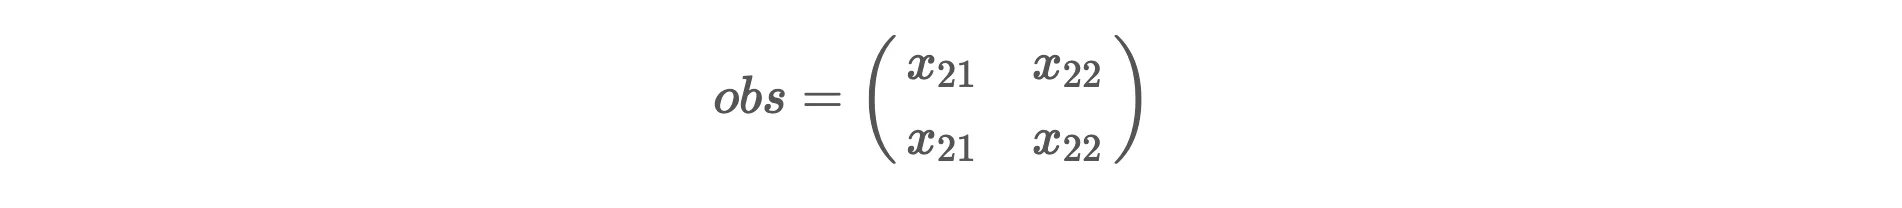
再按 obs 加 pre 加 transition 计算分数:
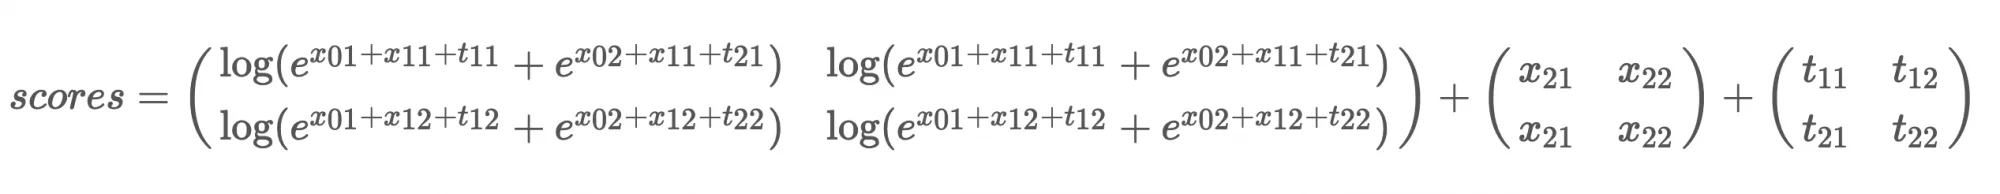
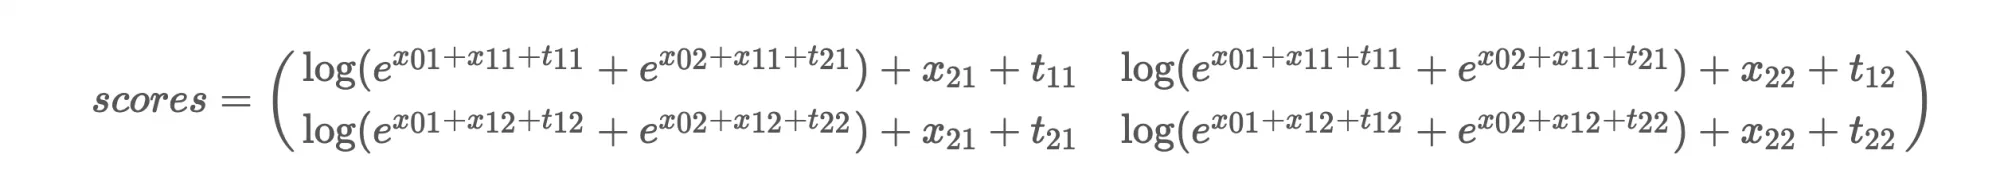
最后对分数矩阵做 log_sum_exp,就得到整句话所有路径分数的对数和:
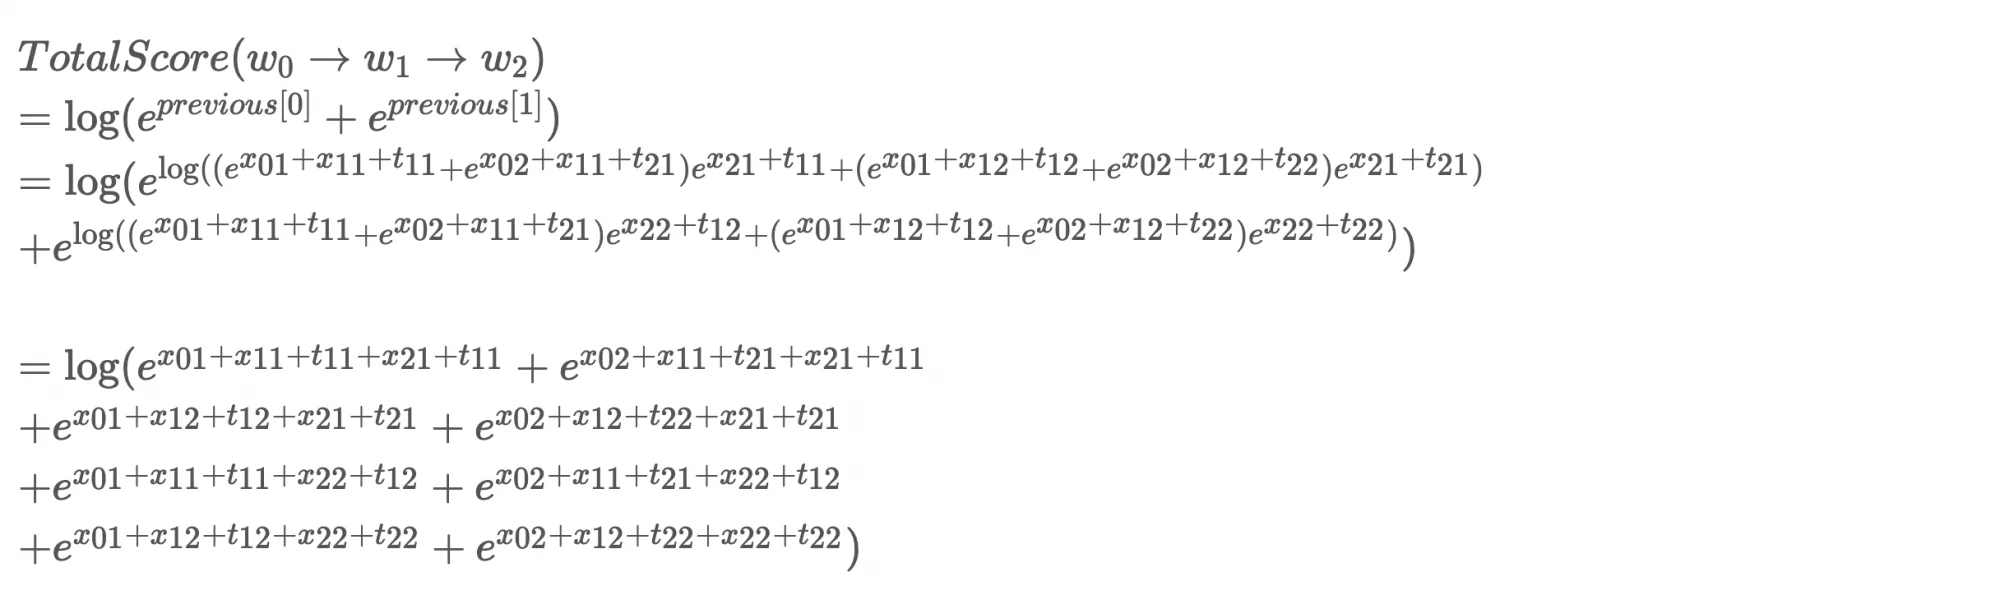
到这里,分母的计算就推导完了。再次感谢原作者给的这个例子,非常直观。
3.3 计算过程小结
把上面的过程总结一下。分母的计算分两部分。第一个字不涉及转移分数,直接算它的 log 损失值。从第二个字开始,重复下面几步:
- 把 pre 转置后横向广播一个维度
- 把 obs 纵向广播一个维度
- 用 pre + obs + transition 计算每条路径的分数
- 计算 \(log(e^{p1} + e^{p2} … e^{pn})\)
- 重复上面的过程,直到所有的字都计算完毕
分子就简单了,直接统计真实路径的发射分数和转移分数,取对数即可。到这里,损失函数就从理论公式变成了可以落地的算法:前向算法。
4. 预测输出
模型训练完,到了真实场景,输入一句话,怎么得到最终的预测结果?思路其实很直接:在所有可能的标签序列里,找到分数最高的那一条。
但直接找,不好计算。候选序列是指数级的,一条条算分数再比大小,跟训练时算分母是一样的问题。所以要用维特比算法。
维特比算法和训练时算分母用的是同一套递推,区别在两点。一是每一步不取 log_sum_exp,而是直接取最大值,二是要把每一步的最大值是从哪个前标签来的记下来。递推到最后一个字,选总分最高的位置当终点,再顺着记下来的来源一层层往回回溯,就还原出整条分数最高的标签序列。
拿到标签序列之后,还有最后一步,把标签翻译回实体。做法是按字顺序扫一遍:遇到 B 开头的标签,记下这个字,继续往后收集连续的 I 标签,直到遇到别的标签为止,收起来的一段字就是一个实体。比如 B-PER、I-PER、I-PER、O,前面三个字拼起来就是人名。B-ORG、I-ORG、I-ORG、I-ORG、O,前面四个字拼起来就是机构名。
整个过程只涉及加法和比较,没有指数计算,所以比训练时算分母更快。训练用前向算法、预测用维特比,两个算法是同一套递推的两面,看懂了训练,预测自然就通了。
小结一下。我们把 BiLSTM + CRF 的原理拆开过了一遍。模型分两层:BiLSTM 提取上下文语义,给每个字打发射分数。CRF 用转移矩阵约束标签衔接。一条序列的分数,等于发射分数加转移分数。损失函数取真实序列分数占所有序列总分和的比例,训练目标就是让这个比例尽量大。分母的指数级计算,用矩阵运算加动态规划解决,也就是前向算法。预测时用同一套递推的维特比算法,找出分数最高的序列,再从标签序列里拼出实体。原理和实现,到这里就都齐了。
 冀公网安备13050302001966号