
在 Character-Level Language Modeling with Deeper Self-Attention 中,作者提到 LSTM 和 RNN 变体在字符级语言建模上有着非常优秀的表现,这得益于它们在学习长距离依赖方面的能力比较强。
基于自注意力机制的 Transformer 模型能够建立更长的依赖,但是它的输入长度仍然受到限制,例如 BERT 模型的输入就是 512。如果我们的输入需要更长的文本,Transformer-XL(Extra Long)就对这个输入限制提出了解决方法。
原始 Transformer 是 Seq2Seq 架构的模型,而 Transformer-XL 只使用了编码器。它并不是直接从 2017 年发布的原始 Transformer 演化而来,而是从 vanilla transformer 演化而来。在 vanilla transformer 中,对更长的输入采取了分段的方式进行训练,这就带来了两个问题。
- 分段会导致输入的长文本按照 max_length 强制分割,破坏了输入文本的语义。
- 在 vanilla transformer 训练时,一个完整的长输入会被分段单独训练,每个段无法参考前面段的信息。
2019 年 Google 提出了 Transformer-XL,这个模型用两种机制来克服上面提到的缺点。
- Recurrence Mechanism,段循环机制。
- Relative Position Encoding,相对位置编码。
1. Recurrence Mechanism
当输入长文本时,Transformer-XL 仍然使用分段的方式进行学习。和 vanilla transformer 不同的是,Transformer-XL 会利用前面段的信息。
既然要利用前面段的信息,那么前面段计算完成之后,每一层的隐藏状态输出都需要缓存下来。这里你可能会问:假设我们输入的文本非常长,前面已经输出了 N 段,缓存 N 段不是需要更多的内存吗?答案是是的。所以,我们可以根据自己的资源情况,来指定需要缓存前面几个段的输出。
注意:前面段的输出只参与当前段的正向计算,不会参与反向传播计算。
那么,它到底是如何利用前面段的信息呢?如下图所示。
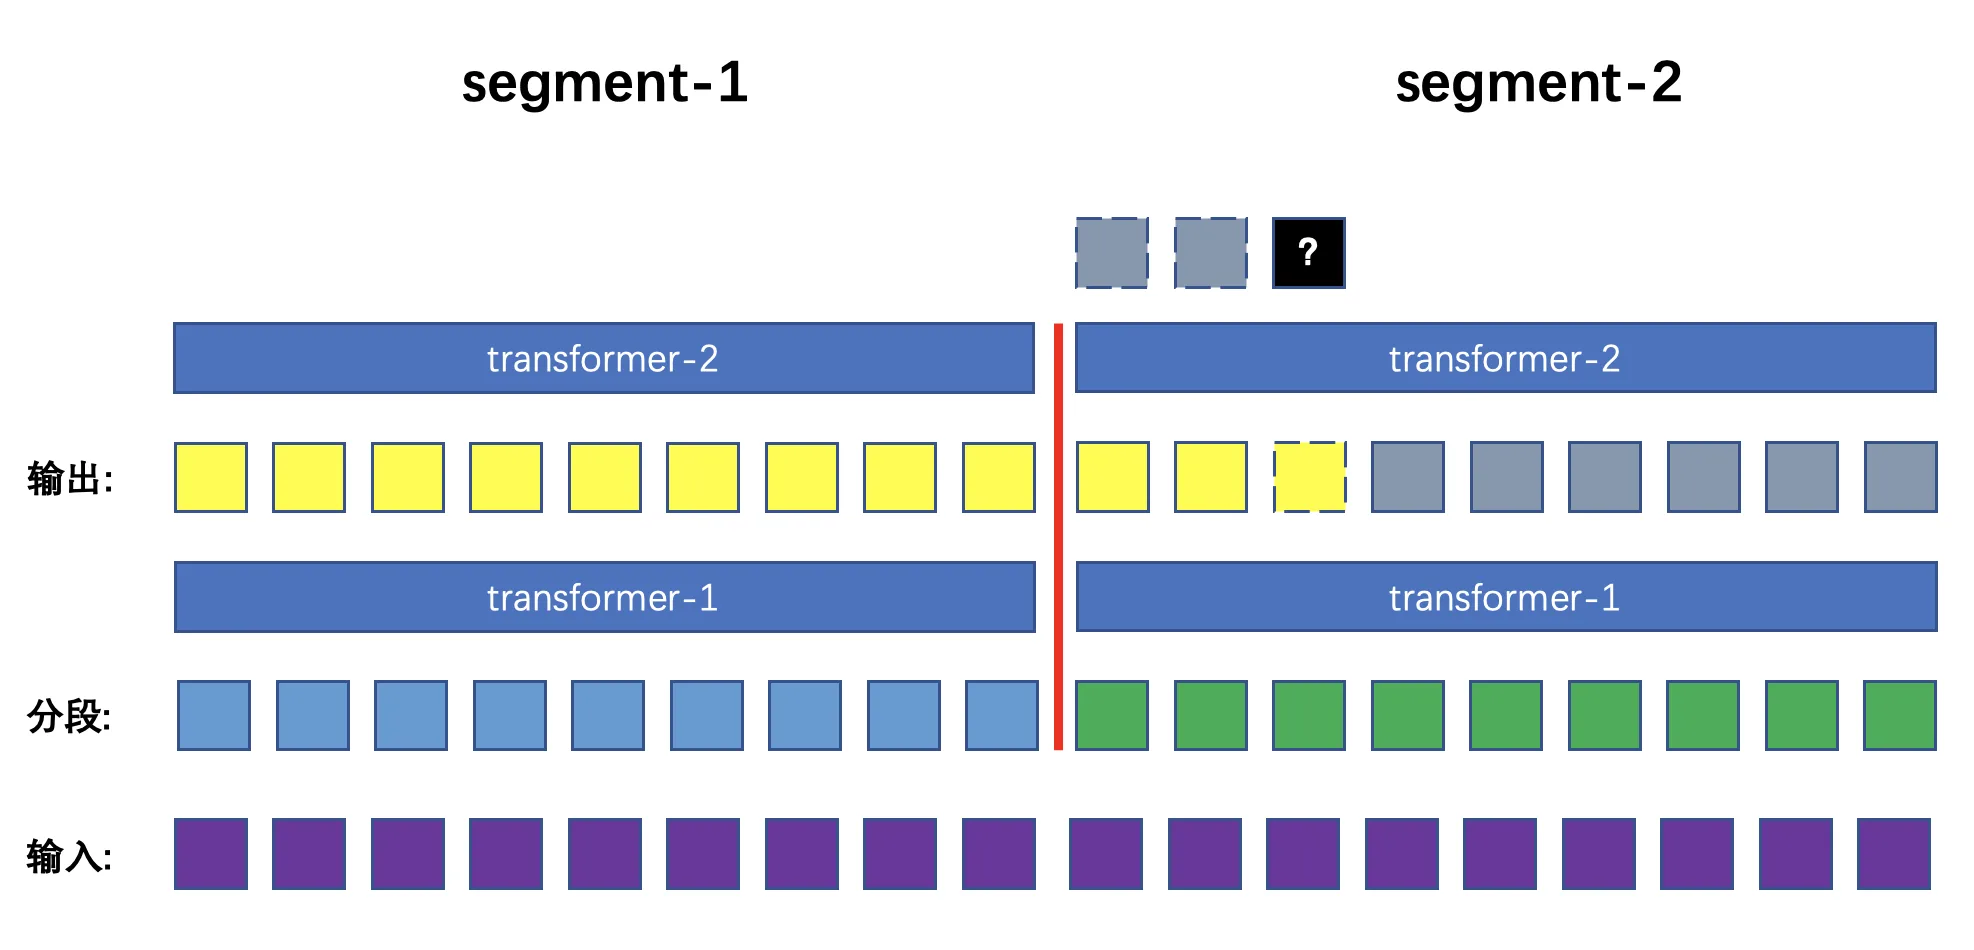
输入的长度为 18,但是模型最多只能处理 9 的长度,此时就需要分段输入模型。在输入第 2 个段时,Transformer-XL 会参考上一个段的信息。我们假设要计算第 2 个段的第 3 个时间步、第 2 层的输出,此时需要的输入是下面两部分。
- 第 2 个段,也就是当前段的上一个层(第 1 层)的输出。
- 第 1 个段,也就是前一个段的第 1 层的输出。
- 最后,把这两个输出 concat 拼接起来。
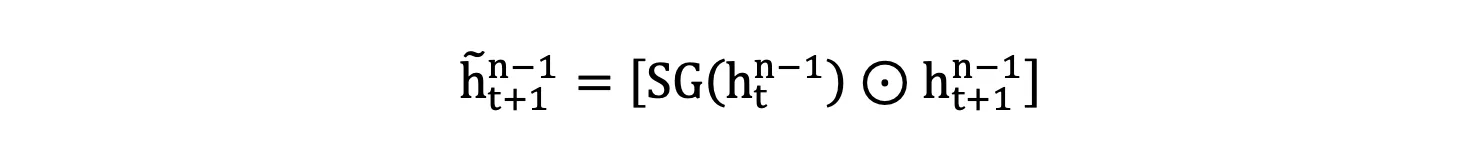
SG 表示 Stop Gradient,也就是上一个段只参与当前段的正向计算,不参与反向传播。根据公式,第一个段的输出 shape 为 (9, 1, 768),第二个段第 1 个层的输出为 (3, 1, 768),把它们拼接起来就变成 (12, 1, 768)。
接下来,我们计算自注意力机制中的 q、k、v,如下公式所示。
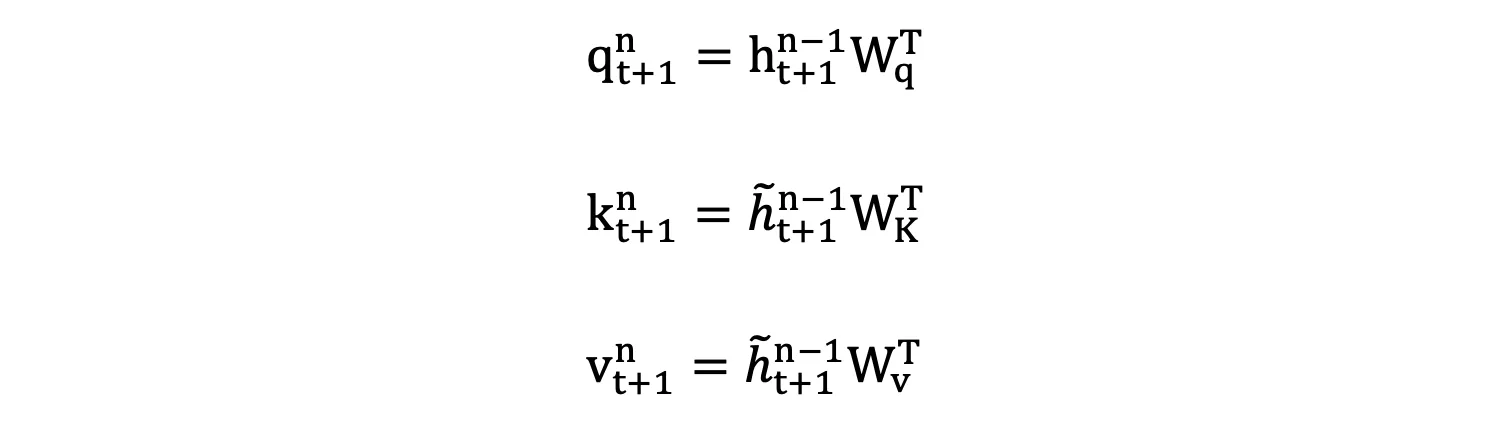
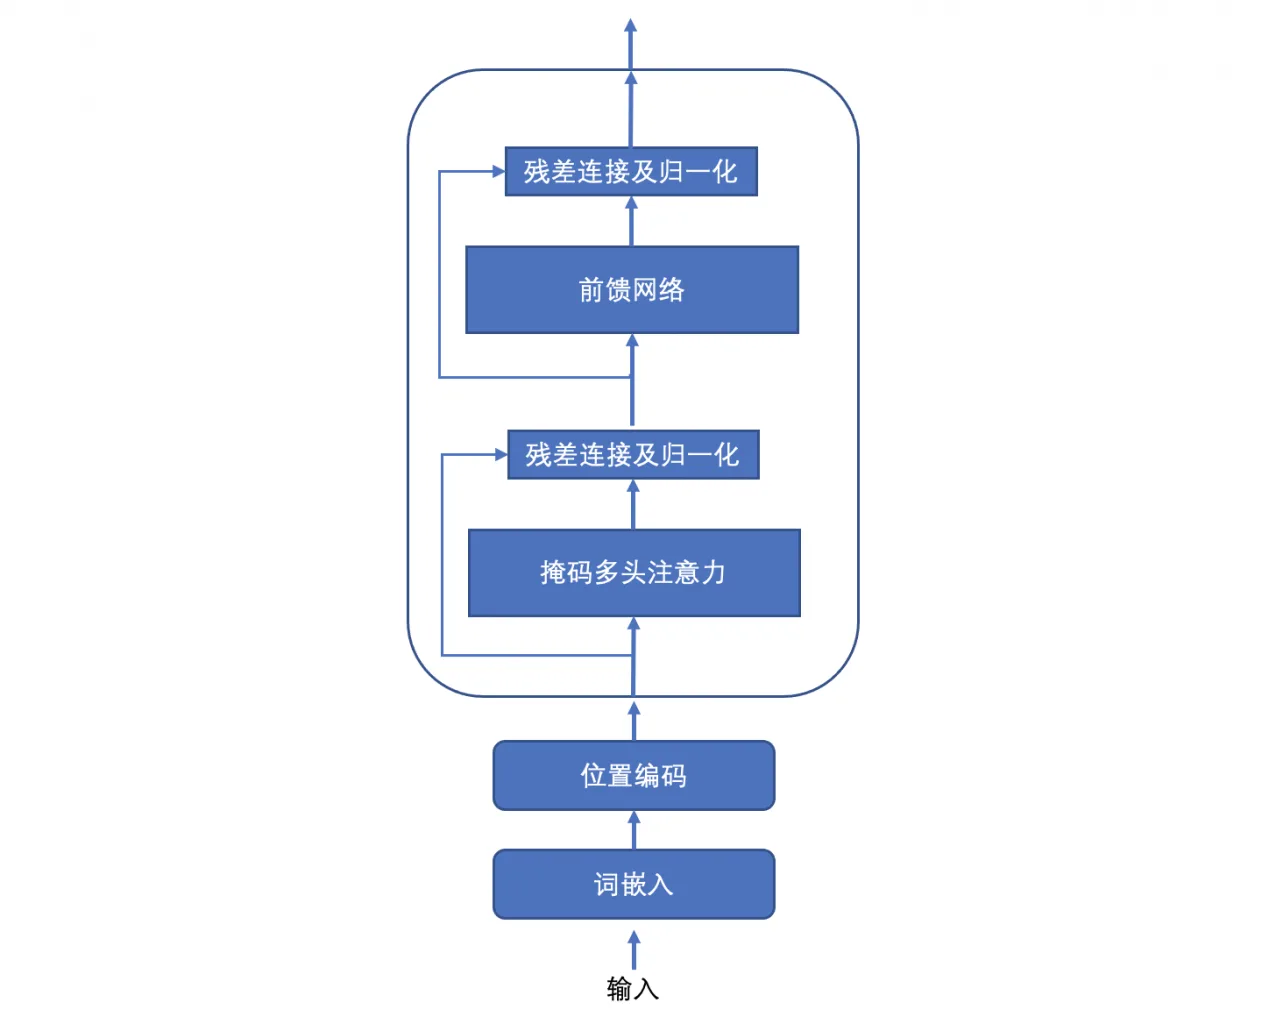
然后,经过 Transformer Layer 层计算,最终得到第 2 个段第 2 层第 3 个时间步的输出。
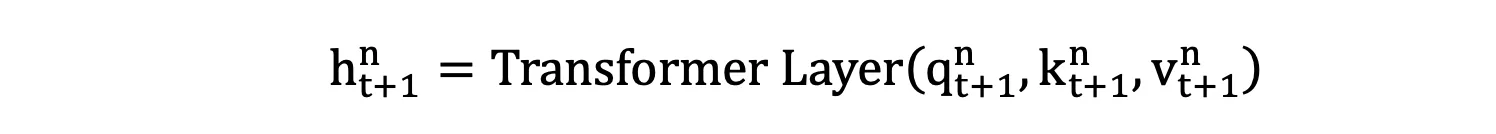
2. Relative Position Encoding
Transformer 中使用的是绝对位置编码。如果在分段输入的场景下仍然使用绝对位置编码,就会导致不同的段中,相同位置的 token 使用的位置编码也是相同的,如下图所示。
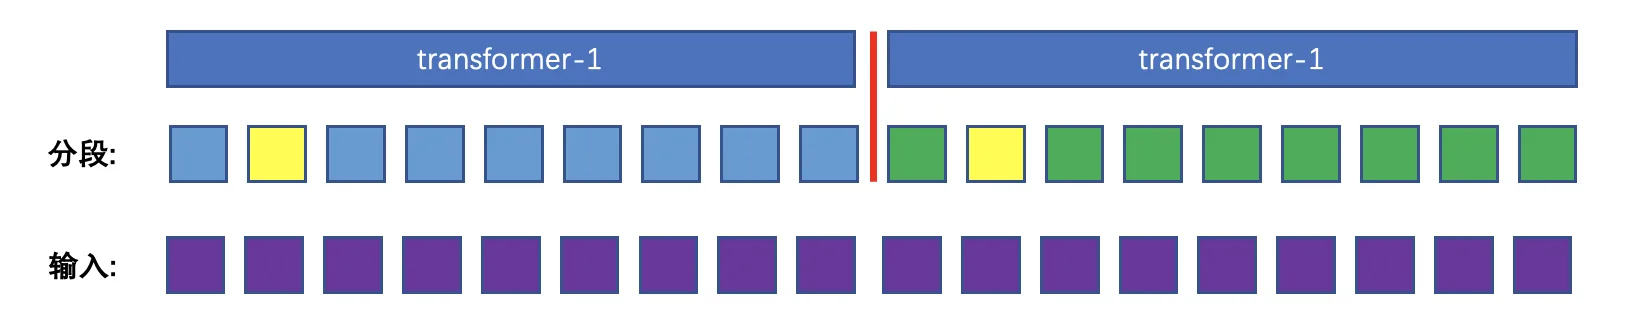
把一个长的输入分成 2 个段,每个段输入时都用绝对位置编码,就像上图里 2 个段中的第二个位置的 token,它们使用的位置编码是一样的。
使用绝对位置编码时,注意力分数的计算如下。
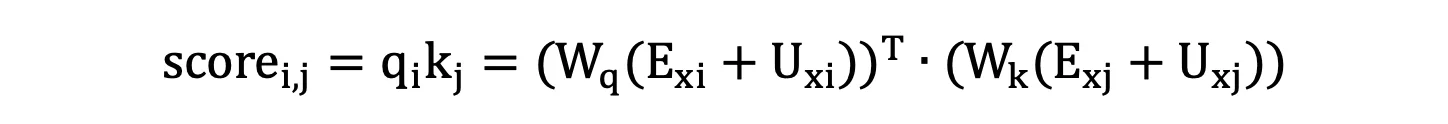
上面这个公式展开之后如下。
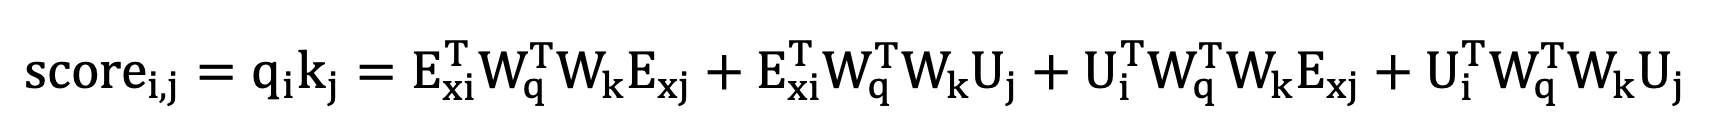
为什么只需要考虑注意力计算呢?这是因为位置编码只在自注意力计算时用到。Transformer-XL 把上面公式中的绝对位置编码换成相对位置编码,这个相对位置编码是一个 LxD 的 sinusoid 矩阵,它不需要学习,计算过程如下。
import torch

# 相对位置编码的最大长度
L = 128
embedding_dim = 512

# 定义矩阵的位置
position = torch.arange(L - 1, -1, -1.0, dtype=torch.float)
inv_freq = 1 / (10000 ** (torch.arange(0.0, embedding_dim, 2.0) / embedding_dim) )

print("position shape:", position.shape)
print("inv_freq shape:", inv_freq.shape)

# position.unsqueeze(1) @ inv_freq.unsqueeze(0)
# (128, 1) @ (1, 256) = (128, 256)
sinusoid = torch.einsum("i,j->ij", position, inv_freq)
print("sinusoid shape:", sinusoid.shape)

# 相对位置编码矩阵
relative_positional_embeddings = torch.cat([sinusoid.sin(), sinusoid.cos()], dim=-1)[:, None, :]
print('relative_positional_embeddings:', relative_positional_embeddings.shape)
接下来,Transformer-XL 对上面的公式做了一些更改,如下公式所示。
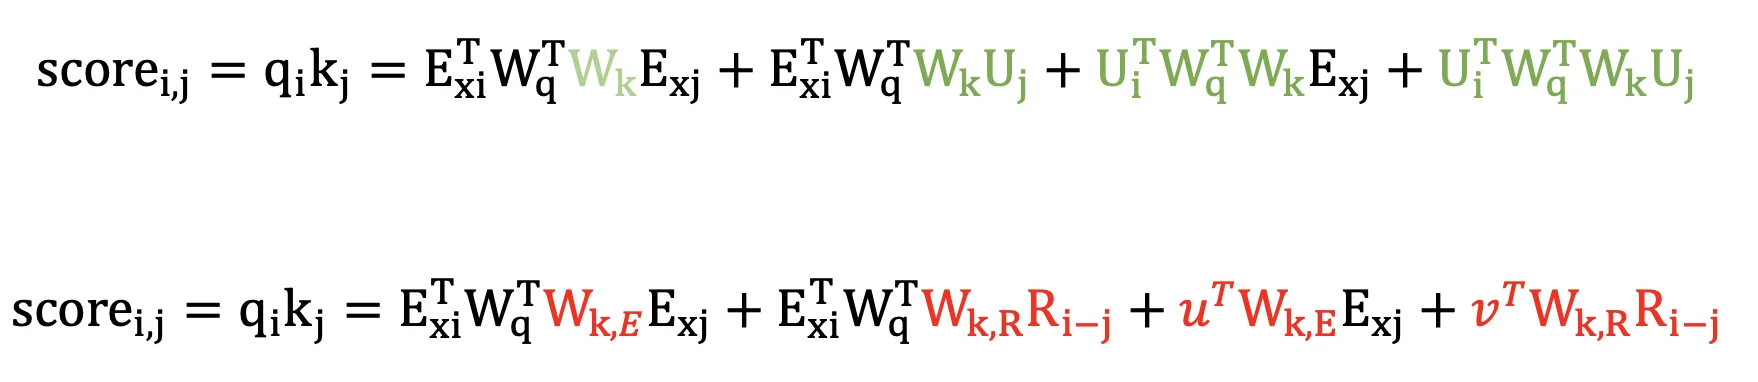
原来的注意力计算过程拆分之后,四项分别表示的是:
- i 的内容对 j 的内容的关注。
- i 的内容对 j 的位置的关注。
- i 的位置对 j 的内容的关注。
- i 的位置对 j 的位置的关注。
对公式进行修改之后,我们逐条来看。
- 原来的 \(W_{K}\) 变成了 \(W_{K,E}\) 和 \(W_{K,R}\),分别表示对内容、对相对位置的参数。这说明了什么呢?原来我们获得 Token 的 Key 向量,只需要一个 \(W_{K}\) 做一次变换就够了,现在需要用 \(W_{K,E}\) 和 \(W_{K,R}\) 两个参数,计算两个 KEY 向量。
- 第三项中 i 位置对 j 内容的注意 \(U_{i}W_{q}\) 变成了 \(u\)。这个变换是什么意思呢?这是因为进行相对位置计算时,当前位置是不变的,是别的 Token 相对我的位置,而我自己的位置信息似乎并不那么重要。但是当前位置还是需要表示,怎么表示呢?让模型去学习吧。所以这里的 u 就是 i 自己的位置,并且该位置的表示是由模型学习得到的。
- 第四项中 i 的位置对 j 位置的注意,这里的位置也变成了 \(v\) 这个可学习的参数。也就是说,第三项、第四项中 i 位置的向量表示,都变成了固定的可学习位置表示。并且,对内容注意、对位置注意的 i 位置向量是不同的。
- 另外,第四项中 j 的相对位置编码,变成了不可学习的、固定的、由 sin+cos 计算得到的矩阵。当然,这个矩阵在最原始的位置编码中表示的是绝对位置编码,在这里则表示相对位置编码。
至此,Transformer-XL 通过上面这些变换,在 self-attention 中引入了相对位置信息,并且引入了 u 和 v 两个可学习的相对位置编码参数。
我们整理一下上面的公式,包含 u 和 v 的两项变成了调整 \(E_{xi}\) 的 bias,通过 u 和 v 调整词嵌入和位置,如下公式所示。
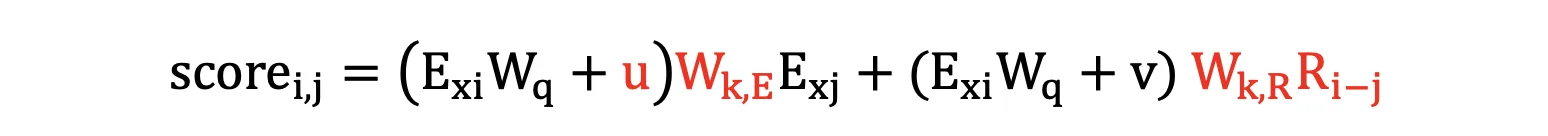
这个公式可以这样理解:i 的 QUERY 在注意 j 的 KEY 时,引入了相对位置编码信息 u。同理,i 的 QUERY 在注意 j 的位置时,引入了相对位置信息 v。
 冀公网安备13050302001966号