1. PageRank
PageRank 算法是谷歌根据网页重要程度给网页排名的算法,该值越高说明网页越重要,当用户进行相关搜索时,越有可能优先展现给用户。
我们通过一个例子来理解 PageRank 的算法计算过程,我们现在有 3 个网页,网页之间都会相互链接,其中链接关系如下图:
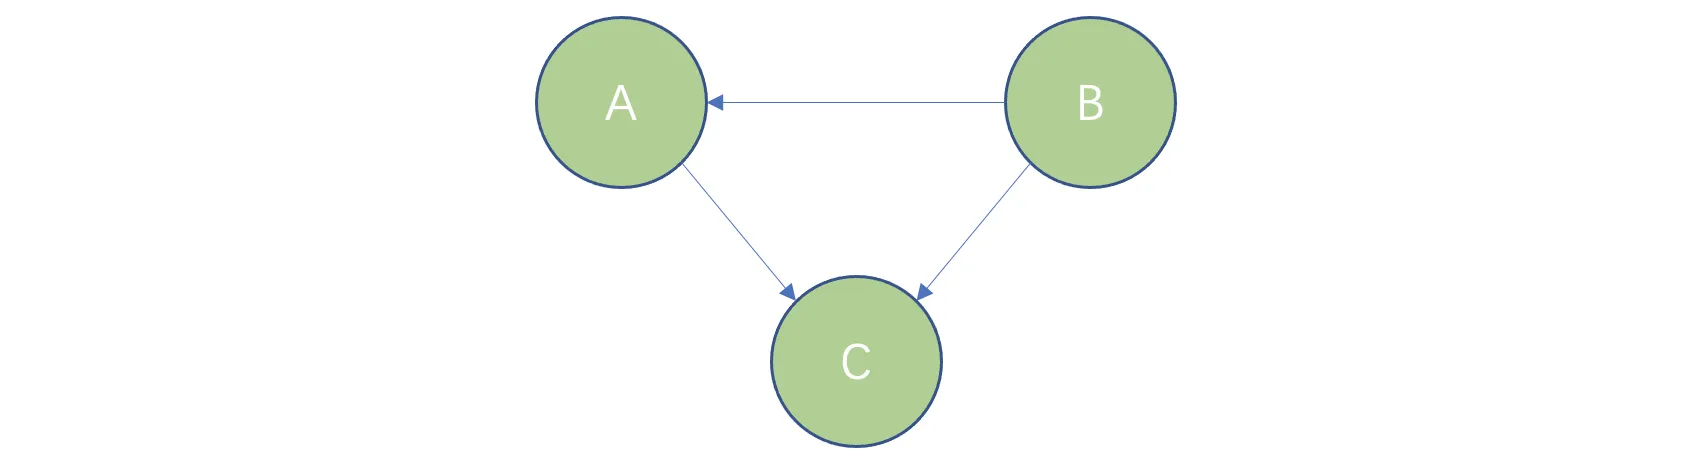
- 网页 A 链接网页 C,对于网页 C 的权重计算提供 1 的贡献;
- 网页 B 链接网页 A、网页 C,网页 B 对网页 A、C 的权重计算提供的贡献分别是 1/2;
- 网页 C 没有链接任何网页,对其他网页权重计算的贡献为 0。
从这个链接关系上来说,A 被其他网页链接了 1 次,B 被其他网页链接 0 次,C 被其他的网页链接了 2 次,看起来 C 网页的 PR 更大一些,更重要一些。所以,PageRank 在评价网页时,是根据其他网页对当前网页的链接数量、链接质量来评价的,即: 比人说你好,你才真的好。
网页 PR 值的计算使用公式表示如下:
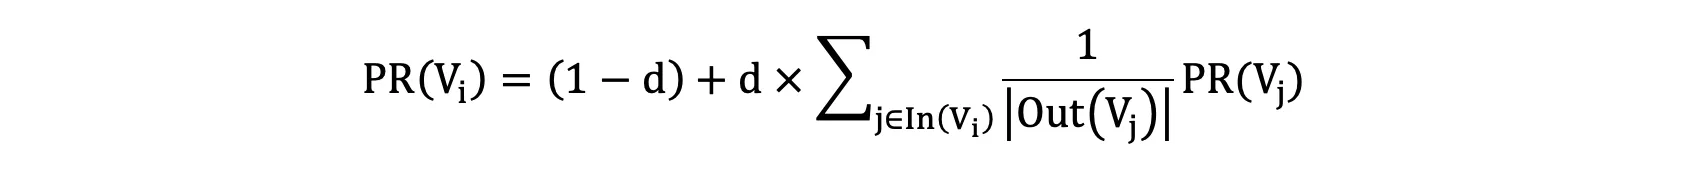
1. In(Vi) 表示链接到网页 Vi 的所有网页,例如:对于 C 网页而言,A B 就是链接的网页
2. Out(Vj) 表示链接网页的出链数量,例如:C 网页的链接网页是 A、B, A 的出链数量是 1,B 出链数量是 2
3. P(Vj) 表示链接网页 A、B 的权重,即权重越大,对于提升 C 网页的权重贡献就越大。
4. d 叫做阻尼系数。当一个网页没有任何外部网页链接到它的时候,那么它的权重为 0,阻尼系数可以给网页一个保底的网页权重值,一般 d 这个值被设置为 0.85。
如果一个网页的出链有 N 个的话,那么对于被链接网页的重要程度的贡献就有 1/N,我们将上面的网页出链贡献,即: out 分之一写成如下矩阵形式:
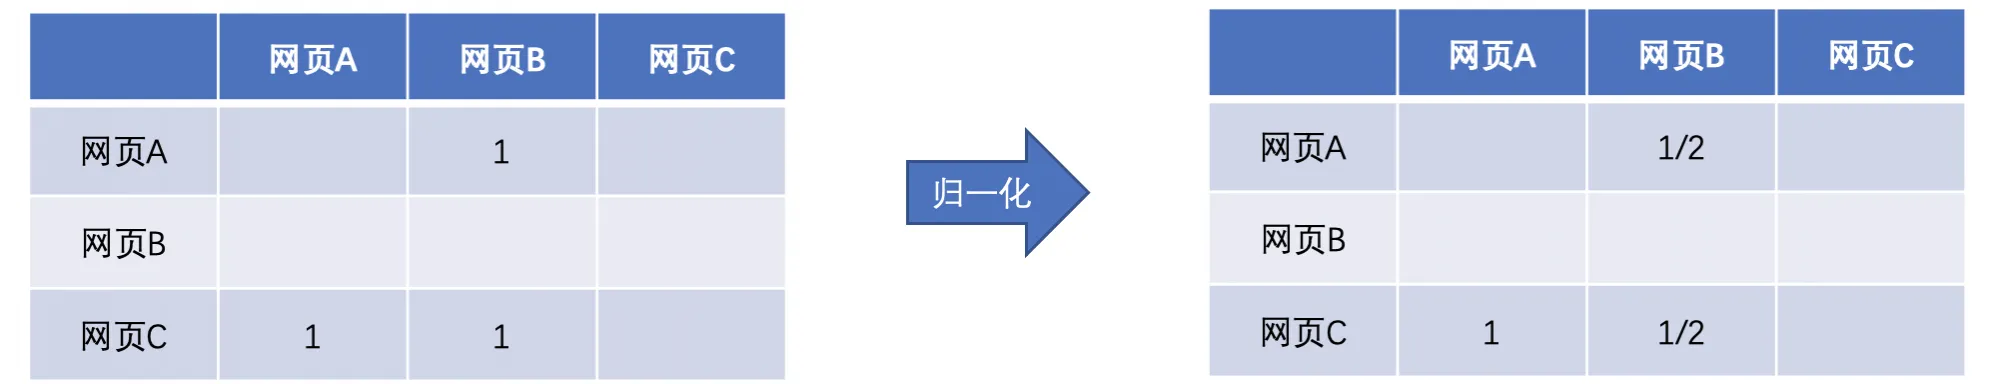
上图中,左图第一行表示:网页B对网页A有链接,而网页A和网页C则没有到网页A的链接。
由于现在我们并不知道每个网页的 PR 值,我们共有 3 个网页,可以先将每个网页的 PR 值初始化为 1/3, 即:(1/3, 1/3, 1/3) 我们这里选择前者初始化。
接下来,如何计算这 3 个网页的重要程度呢?
我们使用上面的 PageRank 公式进行迭代计算,直到 PR 值的计算收敛或者小于某个阈值,如下代码所示:
import torch
import numpy as np


def page_rank():


    # 构建网页链接关系
    graph = torch.tensor([[0, 1, 0],
                         [0, 0, 0],
                         [1, 1, 0]])
    norm_graph = graph / torch.sum(graph, dim=0, keepdim=True)
    # 由于有些列全0,相除之后出现 nan,对这些 nan 列进行替换
    norm_graph[torch.isnan(norm_graph)] = 0

    # 设置网页初始 PR 值
    init_page_rank = torch.tensor([[1/3], [1/3], [1/3]], dtype=torch.float32)
    page_rank = init_page_rank

    # 设置阻尼系数
    d = 0.85

    # 开始迭代计算每个网页的 PR 值
    for _ in range(100):
        page_rank = (1 - d) * init_page_rank + d * (norm_graph @ page_rank)

    print(page_rank.reshape(1, -1))


if __name__ == '__main__':
    page_rank()
输出结果:
tensor([[0.0713, 0.0500, 0.1318]])
从上面的运行结果来看,3 个网页的 PageRank 分别为:网页A:0.0713,网页B: 0.0500,网页C:0.1318,网页 C 更加重要一些,其次是网页 A,最后是网页 B。
2. TextRank
TextRank 构造的是带权无向图,PageRank 构建的是带权有向图。
通过一个例子来理解 TextRank 算法思想,假设内容如下:
人生就像一杯苦茶,不会苦一辈子,但会苦一阵子
接下来,对上面进行分词,去除停用词,去重(保持原有词顺序)之后的结果为:
分词结果:[‘人生’, ‘一杯’, ‘茶’, ‘苦’, ‘一辈子’, ‘总会’, ‘苦’, ‘一阵子’]
去重结果:[‘人生’, ‘一杯’, ‘茶’, ‘苦’, ‘一辈子’, ‘总会’, ‘一阵子’]
我们使用上面的词来构建一个窗口大小为 2 的共现矩阵:
- 窗口滑动第一次 “人生 一杯”,对应 [人生][一杯] 和 [一杯][人生] 位置标注为 1
- 窗口滑动第二次 “一杯 茶”,对应 [一杯][茶] 和 [茶][一杯] 位置标注为 1
- 以此类推构建共现矩阵…
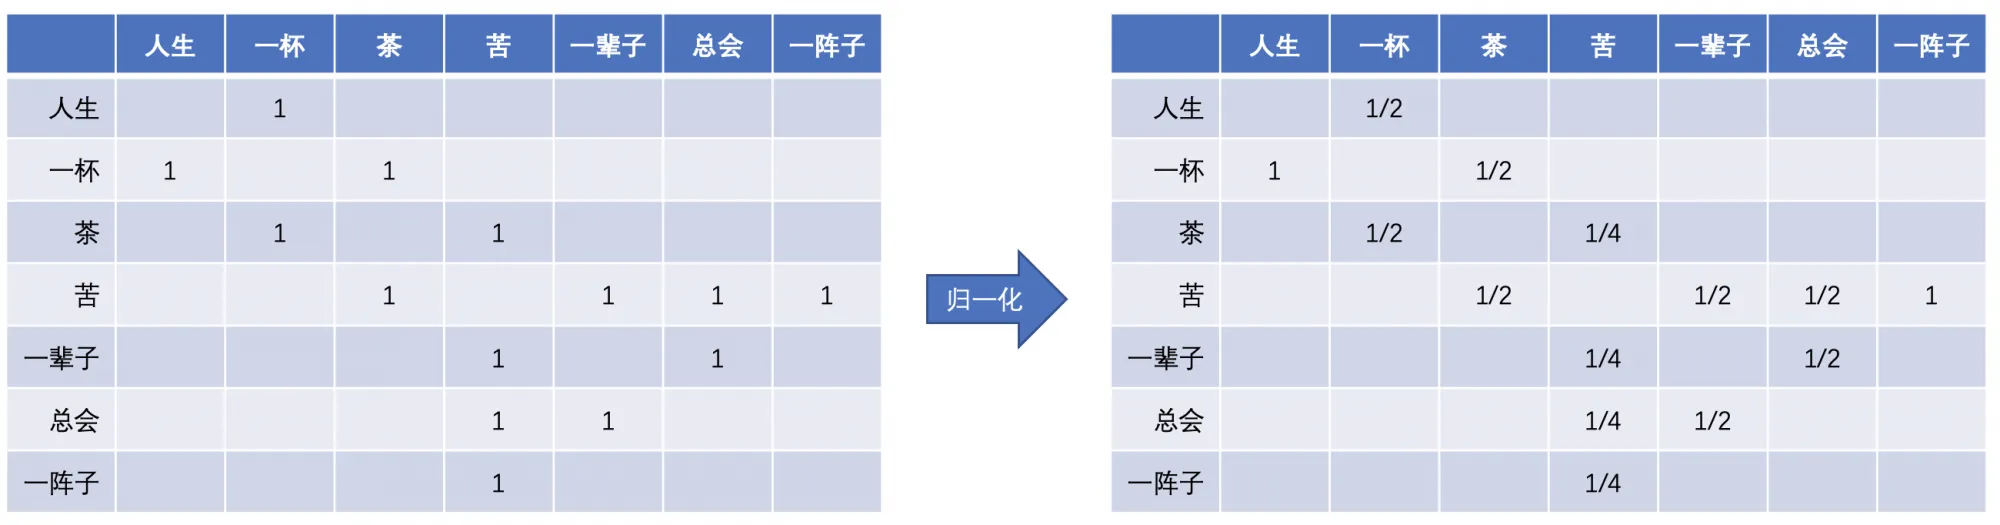
我们以上图为例, 空白部分为 0,横轴表示其他词对当前这个词的计算重要性的贡献,例如:”茶” 这个字的重要性是由 “苦” 这个字贡献了 1/4。
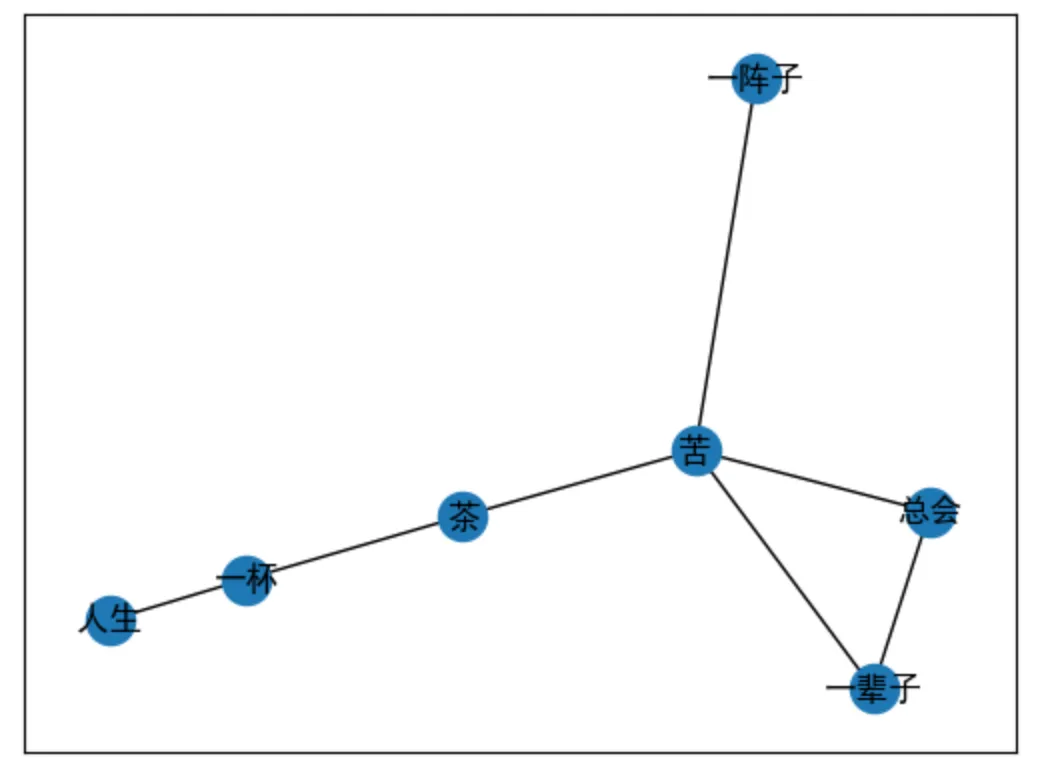
词之间的共现关系如下图所示:
接下来,我们看每个词的 TextRank 计算公式:
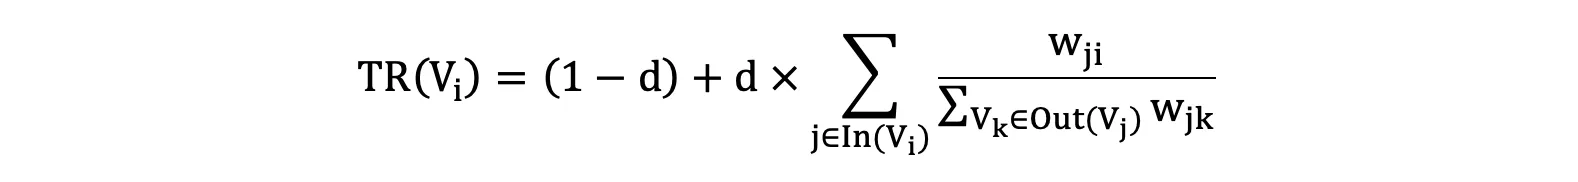
1. TR(Vi) 表示第 i 个词的 TextRank 值。比如:”人生” 这个词的 TextRank 值
2. In(Vi) 表示在窗口内与当前词的具有共现关系的词 。比如:第 i 个词是 “人生”,它的 In(Vi) 就是 “一杯”
3. Out(Vj) 表示某个词对其他的词重要性输出的贡献总和。比如:”苦” 这个字对 “茶” 、”一辈子” 、”总会”、”一阵子”贡献了 1/4.
4. wji 表示第 j 个词对当前的第 i 个词的贡献。比如:”一杯” 这个词对 “人生” 贡献就是 1.
5. d 阻尼系数表示每个词最少的 TextRank 值,避免某些词出现 0 的情况
有了这个归一化的共现矩阵,我们就可以使用上面的公式进行迭代计算了。
import torch
import networkx as nx
import matplotlib.pyplot as plt


def text_rank():

    # 共现矩阵
    graph = torch.tensor([[0, 1, 0, 0, 0, 0, 0],
                         [1, 0, 1, 0, 0, 0, 0],
                         [0, 1, 0, 1, 0, 0, 0],
                         [0, 0, 1, 0, 1, 1, 1],
                         [0, 0, 0, 1, 0, 1, 0],
                         [0, 0, 0, 1, 1, 0, 0],
                         [0, 0, 0, 1, 0, 0, 0]])

    # 共现矩阵归一化
    norm_graph = graph / torch.sum(graph, dim=0, keepdim=True)

    # 绘制词之间的共现关系
    graph = nx.from_numpy_matrix(norm_graph.numpy())
    node_name = { idx: name for idx, name
                  in enumerate(['人生', '一杯', '茶', '苦', '一辈子', '总会', '一阵子'])}
    nx.draw_networkx(graph, labels=node_name)
    plt.show()


    # 每个词的初始 TextRank 值
    init_text_rank = torch.tensor([[1/7],
                                   [1/7],
                                   [1/7],
                                   [1/7],
                                   [1/7],
                                   [1/7],
                                   [1/7]], dtype=torch.float32)
    # 阻尼系数
    d = 0.85
    # 迭代求解
    text_rank = init_text_rank
    for _ in range(100):
        text_rank = (1 - d) * init_text_rank + d * (norm_graph @ text_rank)

    # 每个词的 TextRank 值
    print(text_rank.reshape(1, -1))


if __name__ == '__main__':
    # [‘人生’, ‘一杯’,  ‘茶’,    ‘苦’,    ‘一辈子’,  ‘总会’,  ‘一阵子’]
    # [0.0714, 0.1429, 0.1429,  0.2857,  0.1429,  0.1429,   0.0714]
    text_rank()
程序输出结果:
tensor([[0.0887, 0.1582, 0.1445, 0.2627, 0.1344, 0.1344, 0.0773]])
最终,我们得到这几个词的 TextRank 值为:
| 人生 | 一杯 | 茶 | 苦 | 一辈子 | 总会 | 一阵子 |
| 0.0887 | 0.1582 | 0.1445 | 0.2627 | 0.1344 | 0.1344 | 0.0773 |
从结果来看,”苦”、”一阵子”、”总会”、”一杯” 适合做我们文本的关键词。
 冀公网安备13050302001966号