
分类问题主要分为二分类和多分类。我们先推导 XGB 怎么解决二分类,再来看它怎么处理多分类。
做二分类时,我们一般用 Sigmoid 函数,把模型的输出值映射到 0 到 1 之间,得到模型预测为 1 类别的概率。
我们训练模型的目标很明确,让模型把正样本预测得越准越好,也就是正样本的概率越高越好、负样本的概率越低越好。假设模型预测某个样本为 1 的概率是 P,那预测为 0 的概率就是 1-P。于是某个样本被预测正确的概率可以写成:
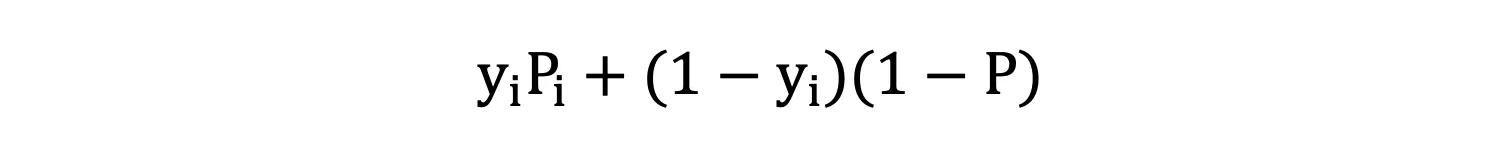
如果该样本的真实类别是 1,那 \(y_{i}\) 取 1,否则取 0。模型希望每个样本代入上面公式后得到的值越大越好。注意这里的 P 就是 Sigmoid 公式的输出,Sigmoid 里的 x 就是模型的输出值。接下来,我们把它代回上面的公式:
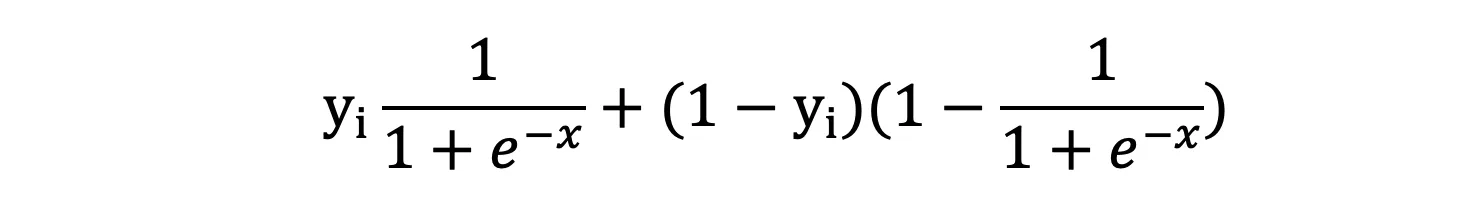
我们对上面公式的每一项取负对数,就变成下面这样:
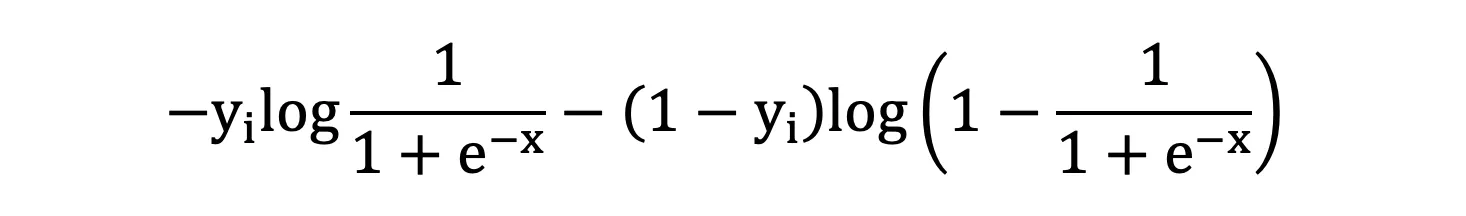
问题就转成希望这个式子越小越好,它就是二分类用的负对数似然损失函数。把它展开化简:
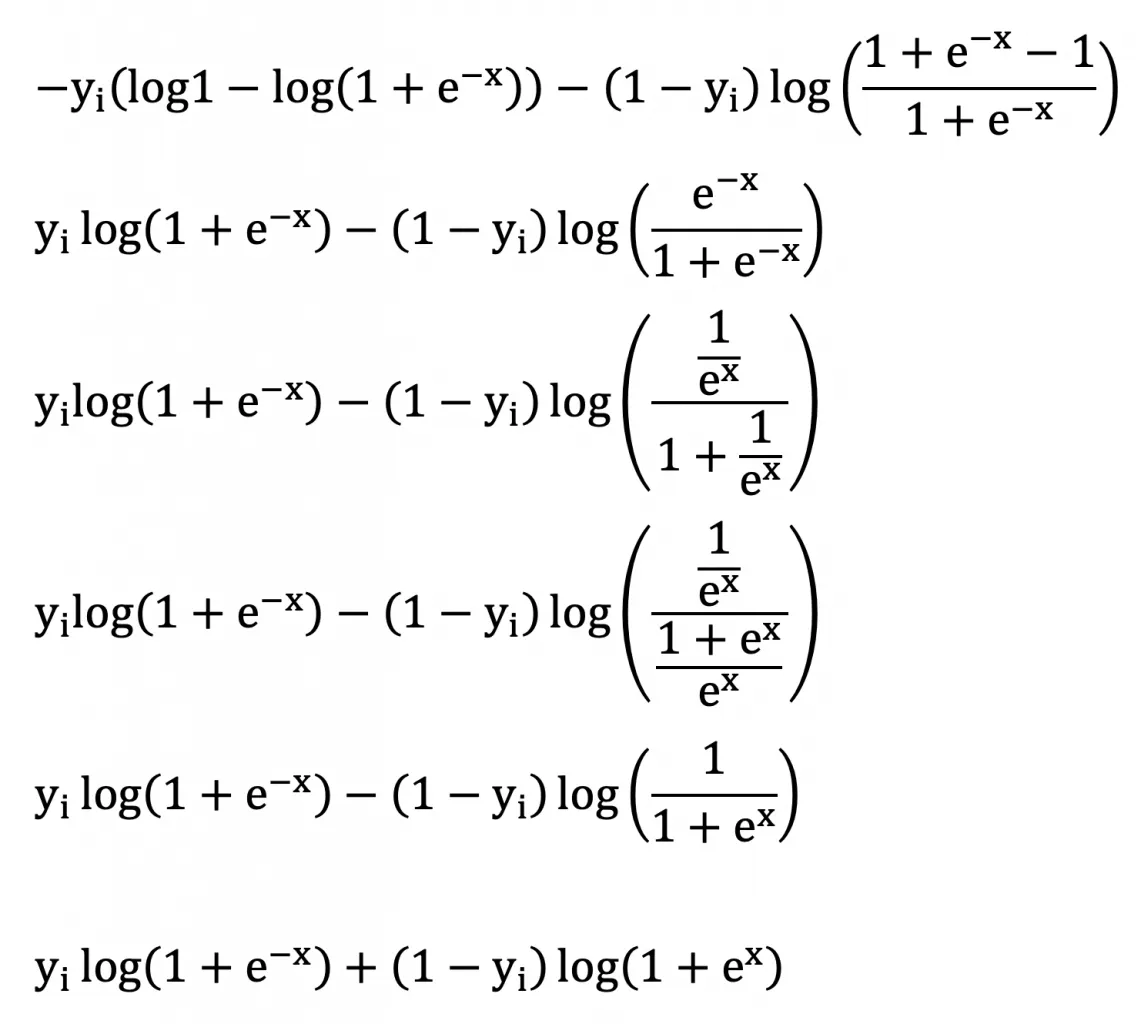
从 XGB 的推导过程我们知道,算分裂增益时要用到样本的一阶导和二阶导。所以我们还得把损失函数的一阶导、二阶导求出来。
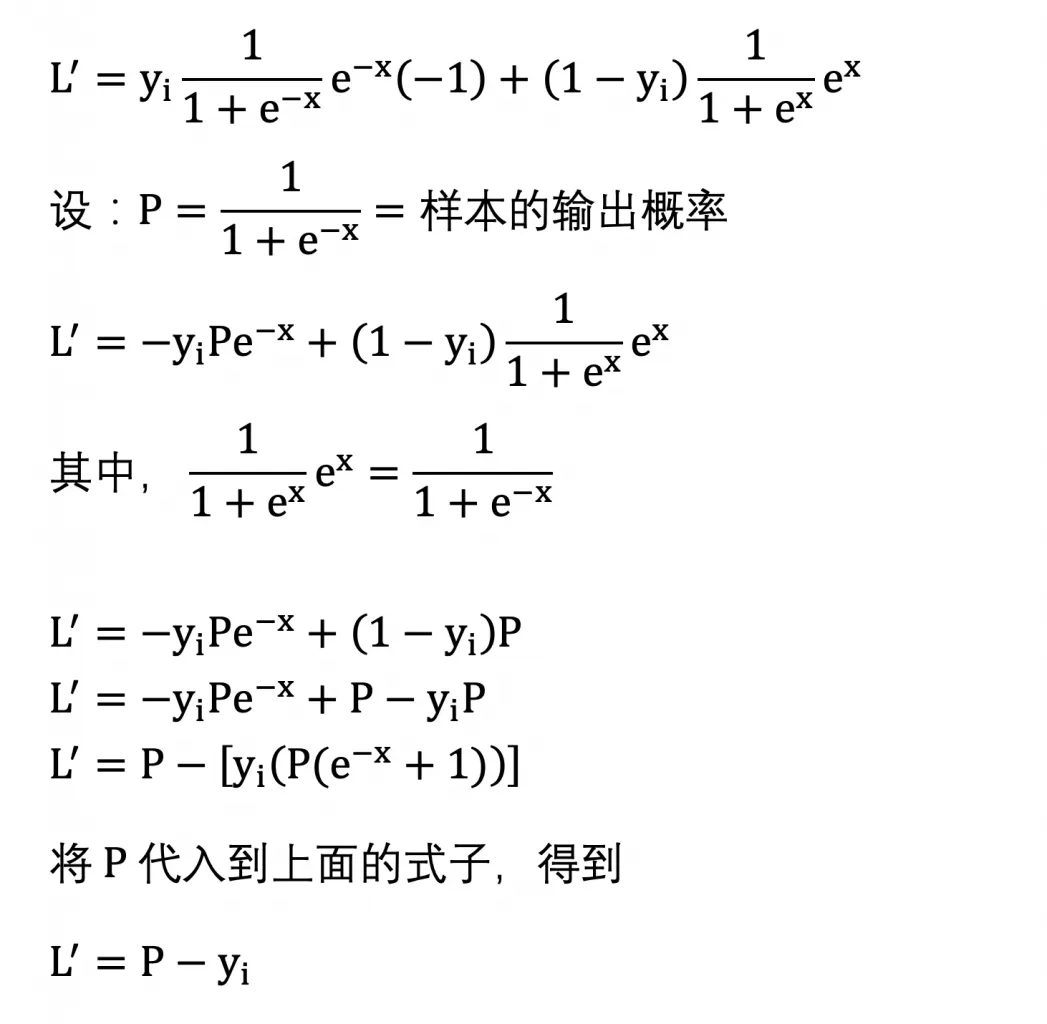
这里要再强调一次,XGB 用的是加法模型,所以损失函数里的 x 指的是前 N-1 棵树输出值的累加。损失函数的一阶导如下:
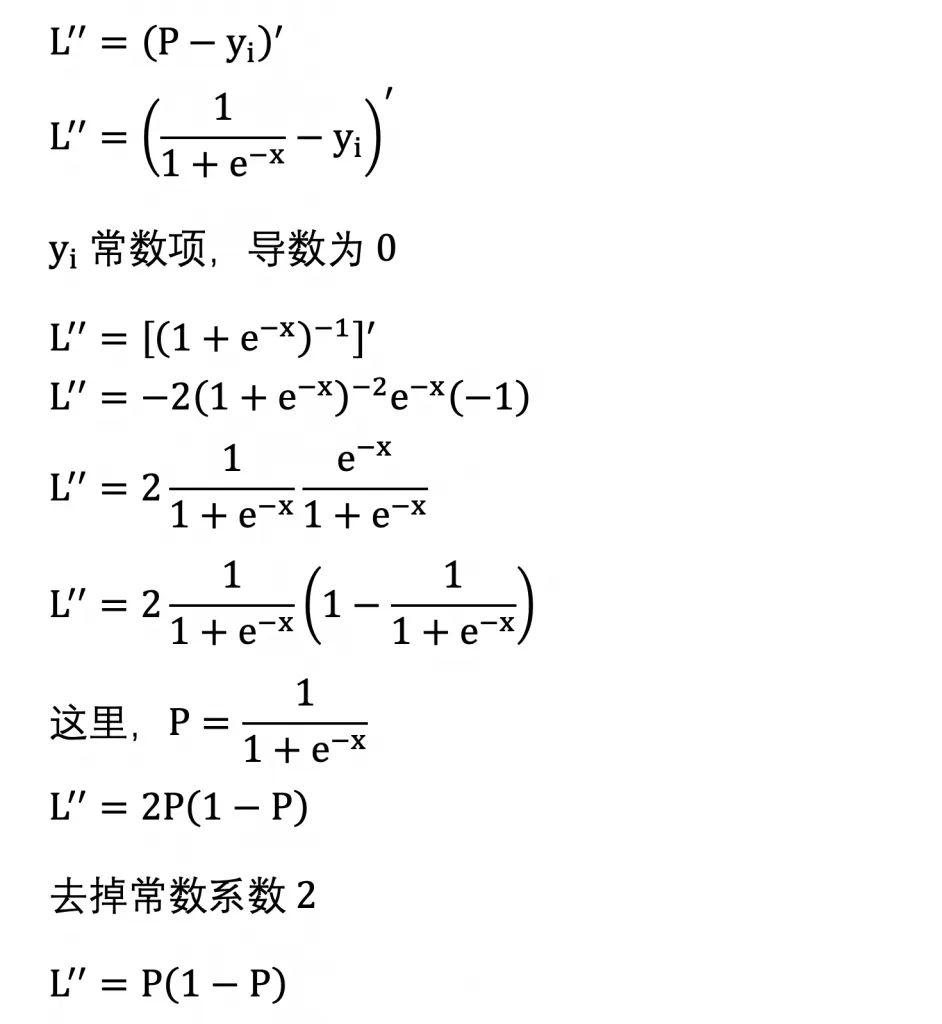
损失函数的二阶导如下:
最后得到损失函数的一阶导、二阶导公式如下:
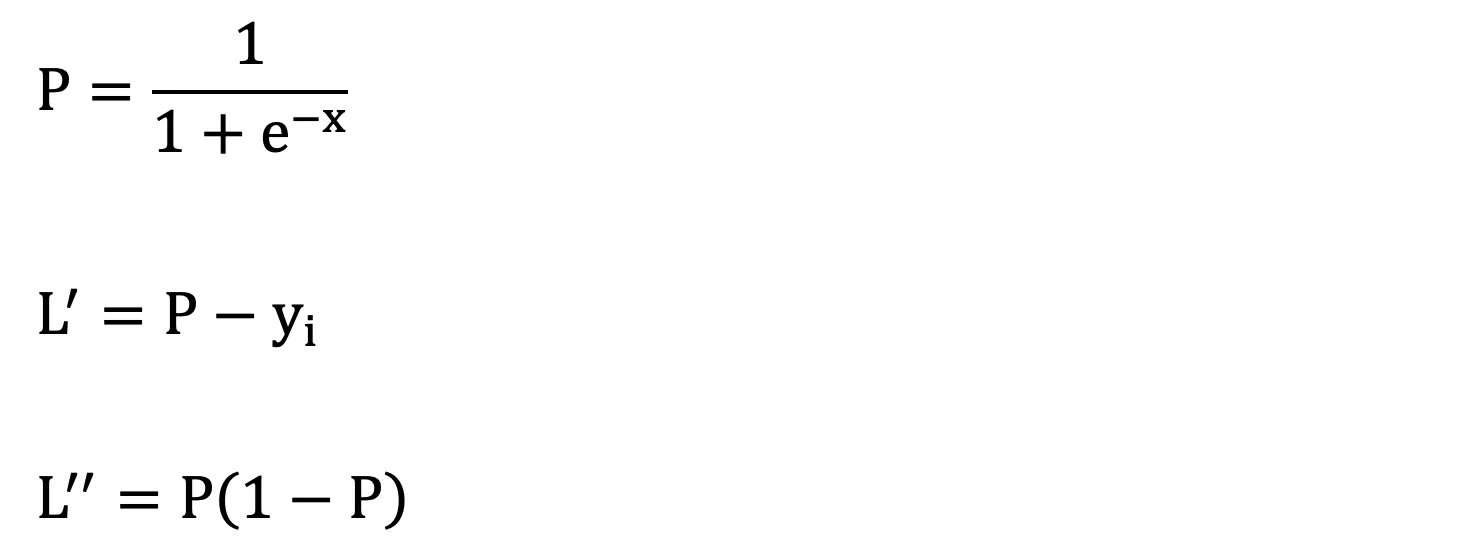
看这些公式会发现,一阶导和二阶导都只和预测概率有关。\(y_{i}\) 是样本的真实目标值,在分类问题里它就是一个概率值,属于 1 类的样本取 1,属于 0 类的样本取 0,P 则是前 N-1 棵树对该样本输出的概率。从一阶导、二阶导也能看出,XGB 每建一棵弱学习器(决策树),都是在逼近样本的目标概率。
我们知道,XGB 里每一棵弱决策树在考虑分裂时,用的是考虑了结构化损失(真实值和目标值的差距,加上树的复杂度)的增益算法。这个增益公式是 XGB 推导出来的,这里直接列出来:
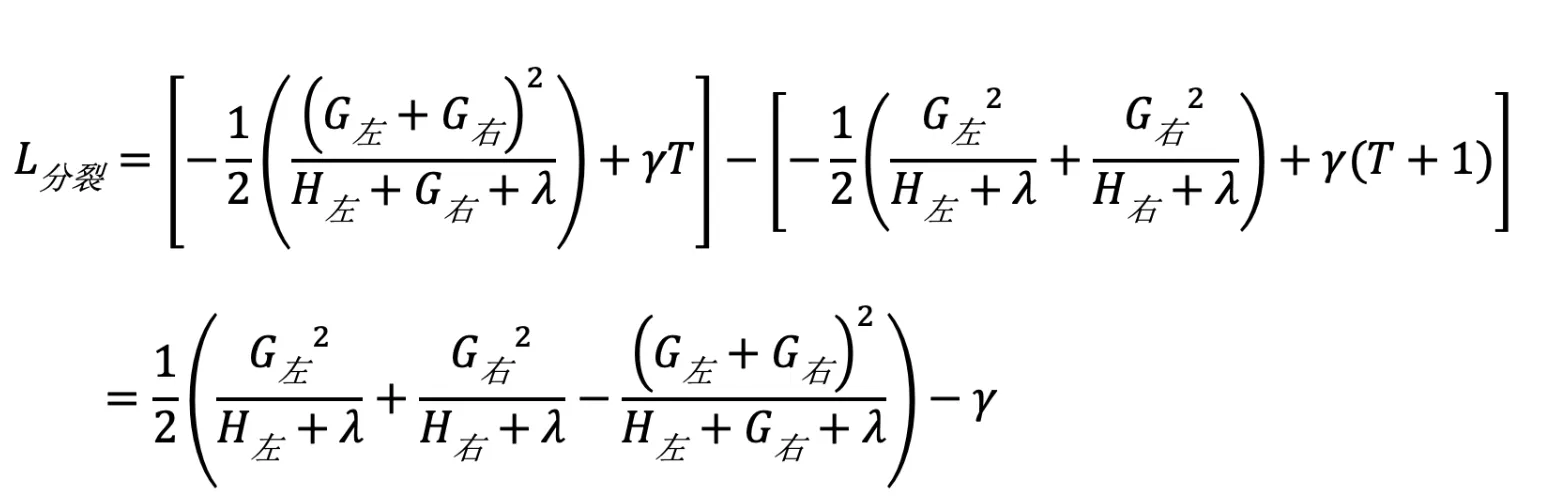
这个分裂增益等于分裂前的损失减去分裂后的损失。如果它大于 0,而且越大,说明分裂后模型对训练样本拟合得越好。所以分裂增益越大越好,我们就逐个计算每个候选分裂点的增益,选增益最大的那个作为最终分裂点。
分裂一直进行,直到触发停止条件,比如某个叶子节点上的样本数低于阈值,或者树的深度达到上限。
还有一点要理解,XGB 最终输出的“样本属于某类的概率”,是把每棵弱决策树的输出值累加起来,再送进 Sigmoid 得到的。注意,单棵弱决策树输出的并不是概率。
那每棵弱决策树的每个叶子节点,输出的值到底是什么呢?它是由落在这个叶子节点上的样本,按下面的公式算出来的(这个公式同样来自 XGB 的推导):
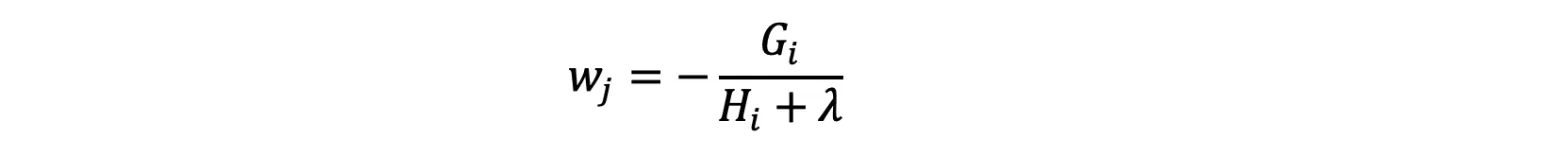
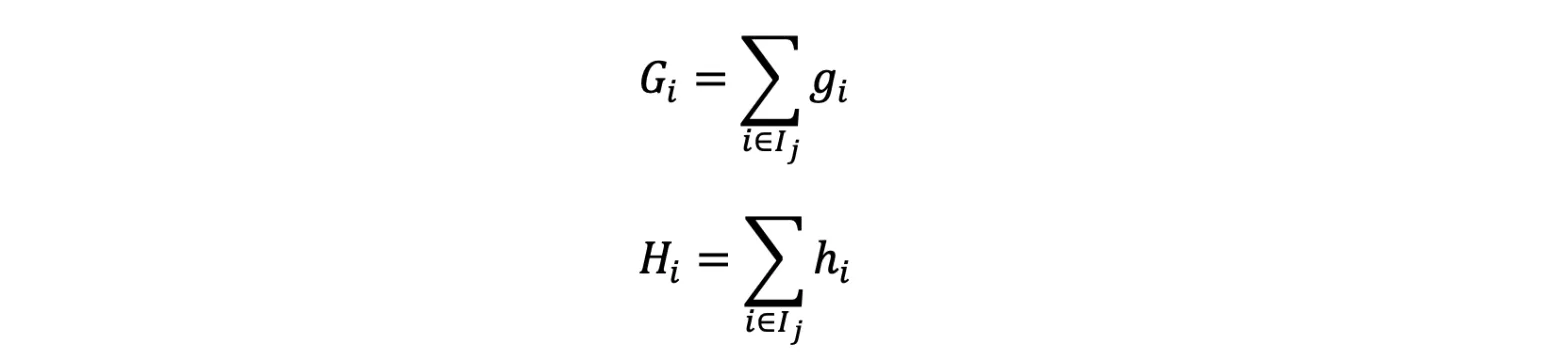
公式里,w 是叶子节点的输出值,它由 \(G_{i}、H_{i}\) 算出来。G 是落在该叶子节点上所有样本的一阶导之和,H 是二阶导之和。λ 是调节叶子输出值的超参数,叶子输出越不稳定,带来的损失就越大,λ 就是这项损失的系数,λ 越大,模型就越看重输出的稳定性。
到这里讲的都是 XGB 解决二分类。那如果类别更多,XGB 又该怎么办呢?
构建二分类 XGB 时,每次迭代只建一棵弱决策树。如果是多分类,比如有 5 个类别,那每次迭代 XGB 会一次建 5 棵弱决策树,分别对应这 5 个类别。
这时来了一个未知样本,要预测它的类别。先把它送进对应各个类别的那一组弱决策树,把各组的输出值(也就是加法结果)算出来,最后送进 softmax,得到它属于各个类别的概率,归到概率最大的那一类。
最后补充一下 XGB 面临的问题和它的优化。我们想一下,当数据集特征很多、样本量也很大时,每次都要对各个特征排序、计算大量切分点的分裂增益,会非常耗时。所以实际中 XGB 用了预排序加分桶的思路,按桶数把每个特征粗略切成 N 个切分点,再算分裂增益。简单说,XGB 训练时并不真的去算每个可能切分点的增益,而是只算这少量粗略切分点的信息增益。
当然,我们也可以让每次建弱决策树时只取特征子集,而不是用全部特征,这样同样能减少训练的计算量。
 冀公网安备13050302001966号