
1. 分段模式
一般我们的知识库都是由大量文档组成的,如果每次用户提问时,都把所有的文档一股脑儿地交给大模型,会带来三个致命的问题。
- 一来,大模型根本无法处理这么大的上下文,很容易超出它的处理上限。
- 二来,输入这么庞大的内容,会极大地增加 token 的消耗,推高使用成本。
- 三来,也是最关键的,面对海量的信息,模型的注意力会被严重稀释,它很难从这么多内容中精准匹配到用户的特定提问,最终导致回答质量大打折扣。
所以,我们需要将知识库里的所有文档进行分块(Chunking)处理。这样一来,每次用户提问时,系统就能像“精准雷达”一样,只把和用户问题最相关的那几个内容片段召回给大模型。这样既省钱、又高效,回答自然也就更准了。
分段有三种常用的模式,通用分段模式、父子分段模式、问答分段模式。
1.1 通用模式
通用分段是 Dify 最基础、默认的单层分块模式。它通过指定符号将文本内容划分为多个块,比如:通过 \n 换行符、句号等等。有时,得到的块可能还是太大,所以,我们一般同时会设置一个分段最大长度。
注意:分段的时候,会有一个重叠长度的设置。即:连续两个分段会有一部分的重叠。例如:
# 分段之前
如果员工无故旷工,会受到对应的处罚。累计旷工达到 2 天,给予书面警告。累计旷工达到 3 天,公司将直接解除劳动关系。该情形下解除合同,公司无需向员工支付经济补偿。

# 分段之后,重叠:累计旷工达到3天,公司将直接解除劳动关系。
Chunk A:如果员工无故旷工,会受到对应的处罚。累计旷工达到2天,给予书面警告。累计旷工达到3天,公司将直接解除劳动关系。
Chunk B:累计旷工达到3天,公司将直接解除劳动关系。该情形下解除合同,公司无需向员工支付经济补偿。
为什么需要重叠呢?假设,我们进行如下分段,两个分段没有重叠:
Chunk1:如果员工无故旷工,会受到对应的处罚。累计旷工达到2天,给予书面警告。累计旷工达到3天,公司将直接解除劳动关系。
Chunk2:该情形下解除合同,公司无需向员工支付经济补偿。
用户提问:员工旷工 3 天,公司需要给补偿金吗?提问的重点是:旷工 3 天 + 是否给补偿金。
检索的时候: Chunk1 里面有:旷工 3 天、解除劳动关系,和用户问题相似度很高,被召回。 Chunk2 只有孤零零一句话:该情形下解除合同,公司无需向员工支付经济补偿。缺少:旷工 3 天这个关键词。相似度低,没有被召回。给到 AI 的参考只有 Chunk1:大模型能看到:旷工 3 天会解除合同。 但是看不到:不需要支付经济补偿。最关键的业务结论丢失了。整套逻辑被切分到两个块,只召回前半块,后半块没捞到。于是 AI 回答:
员工累计旷工达到 3 天,公司可以直接解除劳动关系。至于是否支付经济补偿,文档中没有说明。
如果我们开启重叠长度,设置 30 token。Chunk2 开头带上了触发条件:计旷工达到 3 天,公司将直接解除劳动关系。再跟上补偿规则。大模型拿到完整信息,回答更加准确:
员工累计旷工达到 3 天,公司将直接解除劳动关系,该情形下解除合同,公司无需向员工支付经济补偿。
重叠意味着同一段话可能存在于多个 Chunk 中。这增加了该信息被命中的概率。虽然这会增加一点点存储和计算成本,但换来的是检索准确率的显著提升,这在 RAG 中是非常划算的。
简言之:重叠就是两个相邻 Chunk 之间复制一部分相同文本,用来解决语义被切在中间,一个完整语义被拆到两块。
注意:重叠不是越大越好,也不是越小越好。如果重叠过小,容易把完整一句话、一组问答拆断,上下文丢失。如果重叠太大,会导致分块之间相似度变大,召回的 top k 分块内容高度雷同。通常建议重叠长度设置为最大分块长度的 10% ~ 25%。
对于通用分段模式,我们主要需要关注三个参数:分段分隔符、最大分段长度、分段重叠长度。
1.2 父子模式
我们在对内容进行分块的时候,希望检索的时候能够更加精准,并且召回的内容能够更加全面。一般来讲,块越小,语义越单一,检索的时候越精准,同时生成参考答案的时候,参考的信息就更少,甚至割裂。反过来,块越大,检索的精准度就会下降,但是生成答案参考的信息更多,生成质量能够更好。
对于通用分块模式,其虽然简单,适用性广,但是无法兼顾找得准和答得全。父子分块模式应运而生。它的分块思路特别简单:
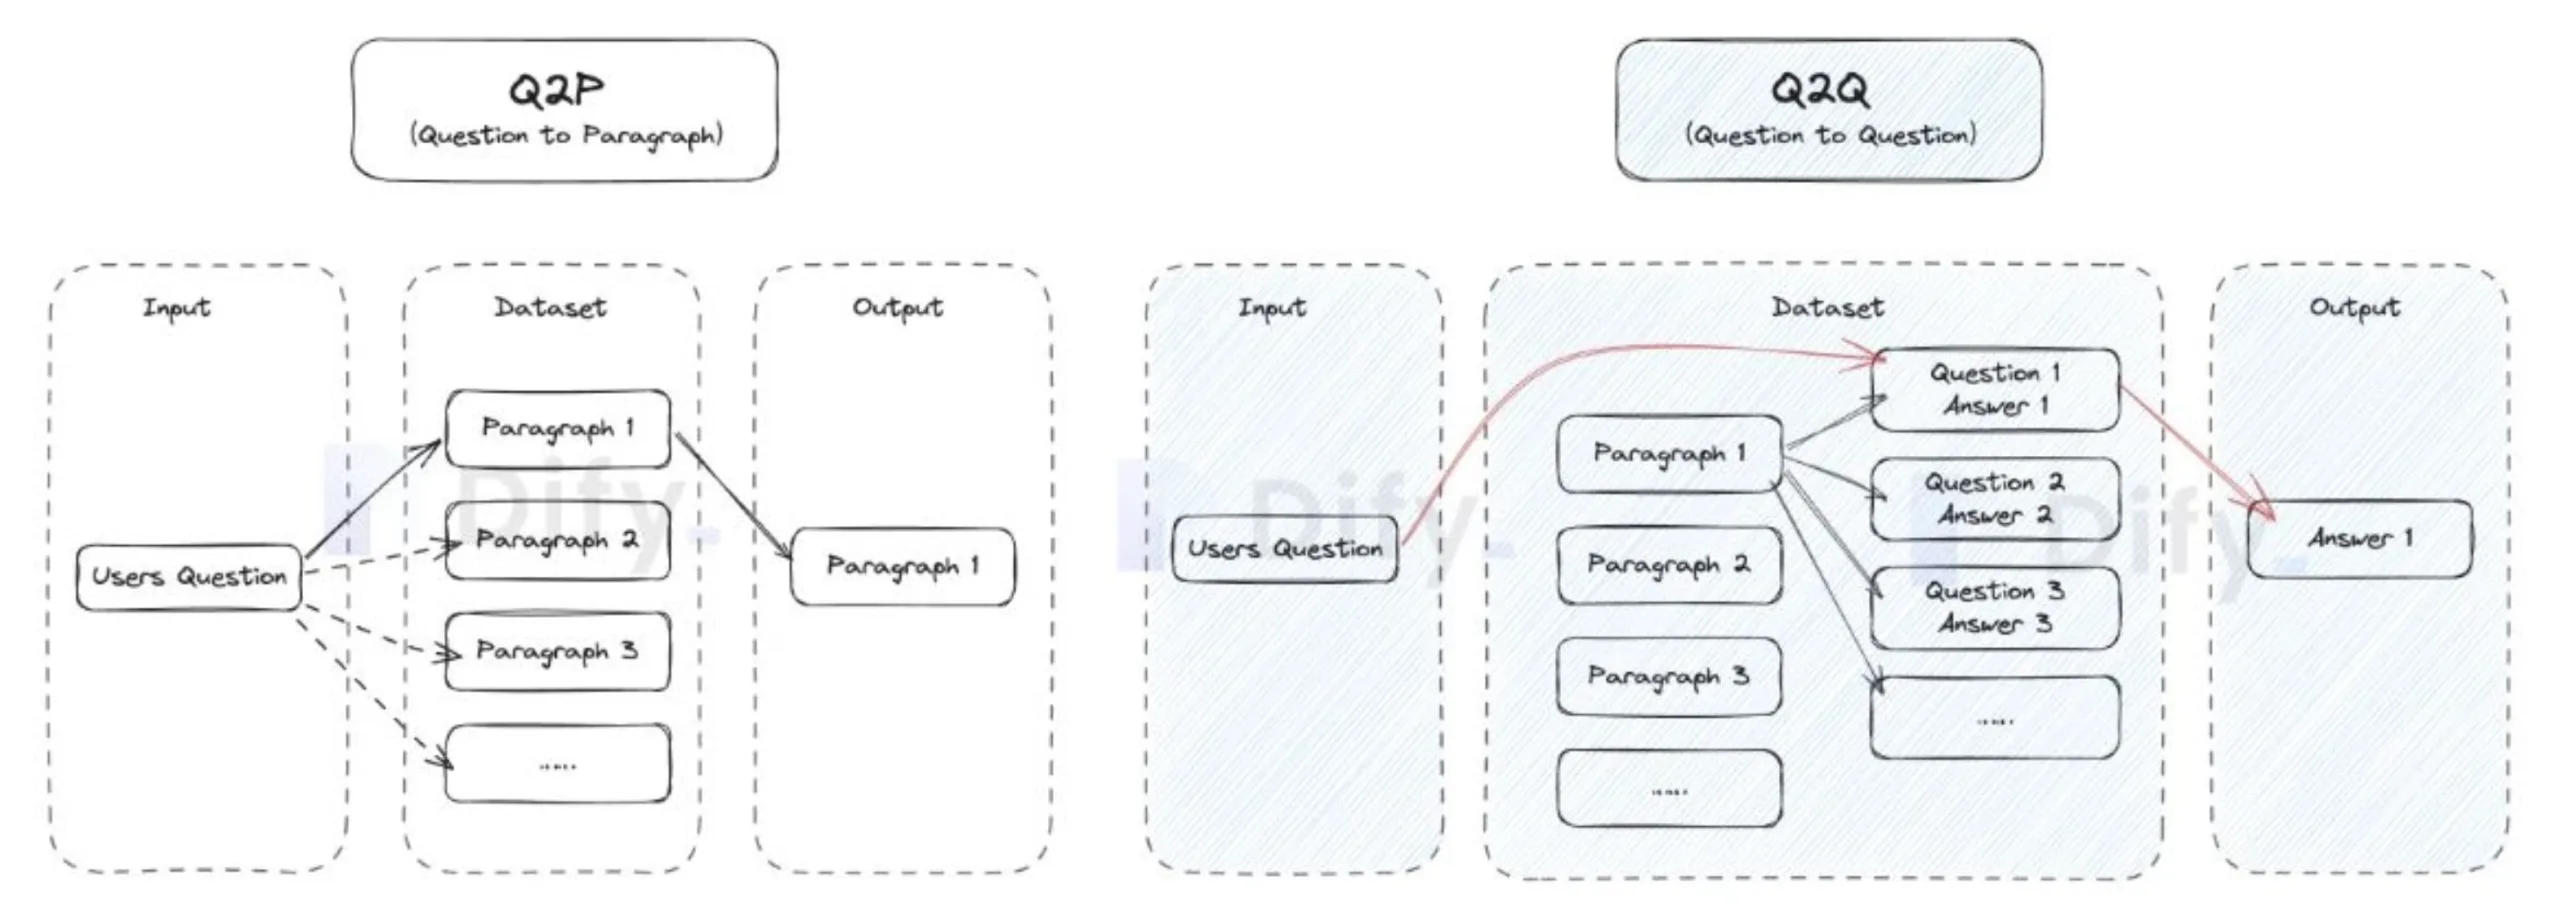
先把知识库分成较大的块,一般以段落为单位,为了避免段落太大,也会设置分段最大长度。然后从每个大分块中,以换行符或者句子为单位,分出来多个子块。
在检索的时候,就用匹配子快,如果子快匹配上了,就返回其所在的大的块。这样就能合理的兼顾找得准和答得全的问题了。
对于父子分块模式,我们需要设置:父块分隔符、最大父块长度、子块分隔符、子块最大长度。
1.3 QA 模式
虽然父子分块模式在一定程度上兼顾了检索的精准度与回答的全面性,但它依然存在明显的局限性。首先,它本质上仍是将用户的问题与原始文本块进行直接匹配,由于用户提问的表达方式与原文往往存在语义鸿沟,这种匹配方式仍有盲区。其次,在召回阶段,系统返回的完整父块中可能包含大量与当前问题无关的冗余信息,这些“噪声”会分散大模型的注意力,进而影响最终生成的回答质量。
为了进一步突破找得准与答得准的瓶颈,QA 分块模式应运而生。它的具体做法是先对原始内容进行分块,然后利用大语言模型针对每个文本块的内容,预先生成一系列可能的问题和对应的答案。当用户进行检索时,系统不再匹配原始文本,而是用用户的问题去匹配这些预先由大模型生成的问题。一旦匹配成功,系统会直接返回该问题所对应的生成答案,而不是原始的文本块。
这种用问题匹配问题,返回精准答案的模式,极大地缩小了语义空间的差距,使得检索与生成的结果更加精准。不过,这种模式也有其代价:它需要在入库前对每个文本块额外调用大模型来生成问答对,这不仅会增加预处理的时间和 Token 消耗成本,而且检索的最终效果高度依赖于大模型生成内容的质量。
2. 检索方式
2.1 关键词检索
在构建知识库时,Dify 会对用于检索的 Chunk 进行分词,并根据分词结果构建倒排索引(Inverted Index)。所谓倒排索引,与传统的正向索引截然相反:正向索引是通过文档去查找它包含哪些单词,而倒排索引则是通过单词去查找包含它的文档。
例如,假设知识库中有以下三个 Chunk:
chunk 1:苹果发布了新款手机
chunk 2:苹果手机销量很好
chunk 3:今天天气很好
构建正向索引:
chunk 1 -> [苹果, 发布, 新款, 手机]
chunk 2 -> [苹果, 手机, 销量, 很好]
chunk 3 -> [今天, 天气, 很好]
构建反向索引:
苹果 -> [chunk 1, chunk 2]
手机 -> [chunk 1, chunk 2]
销量 -> [chunk 2]
很好 -> [chunk 2, chunk 3]
天气 -> [chunk 3]
这样,当用户搜索手机时,系统就不需要遍历知识库中的所有 Chunk,再逐个判断是否包含手机。它只需要在倒排索引中查找手机这个关键词,就可以快速得到:
手机 -> [chunk 1, chunk 2]
简言之,倒排索引主要负责根据用户输入的关键词,快速找到可能相关的 Chunk,缩小检索范围。
得到候选 Chunk 后,系统再根据一定的相关性评分方法计算它们与用户输入的匹配程度,并按照得分从高到低进行排序,分数越高,排名越靠前。
例如,用户搜索苹果手机,如果某个 Chunk 同时命中了苹果和手机两个关键词,而另一个 Chunk 只命中了苹果,那么前者通常会具有更高的关键词相关性,排名也会更加靠前。
2.2 语义检索
传统的关键词检索主要依赖词汇层面的匹配。如果用户的表达方式与文档中的词汇差异较大,即使两者表达的是相同的意思,也可能出现匹配不足、漏召回等问题。
例如:知识库中有这样一段内容:
员工因个人原因需要暂时离开工作岗位的,可以申请事假。
用户的问题是:
我有私人事情要出去一天,应该申请什么假?
虽然两者表达的意思比较接近,但使用的词并不完全相同:
用户:私人事情、出去一天
文档:个人原因、离开工作岗位、事假
如果依赖关键词匹配,就可能因为缺少相同的关键词,而无法很好地召回这段内容。为了解决这个问题,可以引入基于嵌入向量的语义检索。
语义检索不再只关注用户和文档中是否出现相同的词,而是通过比较两段文本的语义是否接近来进行匹配。即使用户的提问与原始文本使用了不同的词汇,只要表达的意思比较接近,也有机会检索到相关内容,因此具有更好的语义泛化能力。
它的具体做法是:使用嵌入模型,将文本转换成能够表示其语义信息的向量,并将这些向量存储起来。当用户发起查询时,再将用户的问题转换成向量,通过计算查询向量与文本向量之间的相似度,找到语义上比较接近的内容。
不过,语义检索也存在一定的局限性。例如知识库中有:
文档1:华为 Mate 60 Pro,电池容量为 5000mAh,支持 88W 有线快充。
文档2:华为 Mate 60,电池容量为 4750mAh,支持 66W 有线快充。
文档3:华为 Mate 60 Pro+,电池容量为 5000mAh,支持 88W 有线快充。
用户提问:Mate 60 Pro 的电池容量是多少?
如果只使用语义检索,这几个文档都在介绍 Mate 60 系列手机,语义非常接近,因此可能会同时召回多个文档。而加入关键词检索后,Mate 60 Pro 这个明确的关键词能够帮助系统优先匹配包含该型号的文档,从而减少其他型号的干扰。
因此,在实际业务中,通常会采用向量检索 + 关键词检索的混合检索方式。语义检索擅长理解意思,关键词检索擅长匹配具体词。单纯依赖语义检索容易混淆相似内容,将两者结合,可以同时兼顾语义相关性和关键词的精确匹配。
 冀公网安备13050302001966号