


SpanBERT 是 Facebook AI 在 2019 年提出的一个改进版 BERT。它的核心改进点在于 增强对 span(文本片段)的表示能力,所以在 实体识别、关系抽取 这类任务上比 BERT 表现更好。具体改了三处:
- Span-based Masking(基于 Span 的掩码机制)。BERT 用的是 单个 token 的随机掩码,SpanBERT 改成 对连续片段(span)做掩码。这样模型能学到跨多个 token 的上下文信息,特别适合实体识别和关系抽取。
- Span Boundary Objective (SBO)(Span 边界目标)。掩码一个 span 时,模型不只要预测被遮住的 token,还要结合这个 span 两端边界的隐藏向量,从而把整个 span 表示得更好。
- 去掉 NSP 任务(Next Sentence Prediction)。SpanBERT 把 BERT 的 NSP 任务删了,转而更专注地学 句子内部的 span 表示。
GitHub:https://github.com/facebookresearch/SpanBERT
Paper:https://arxiv.org/abs/1907.10529
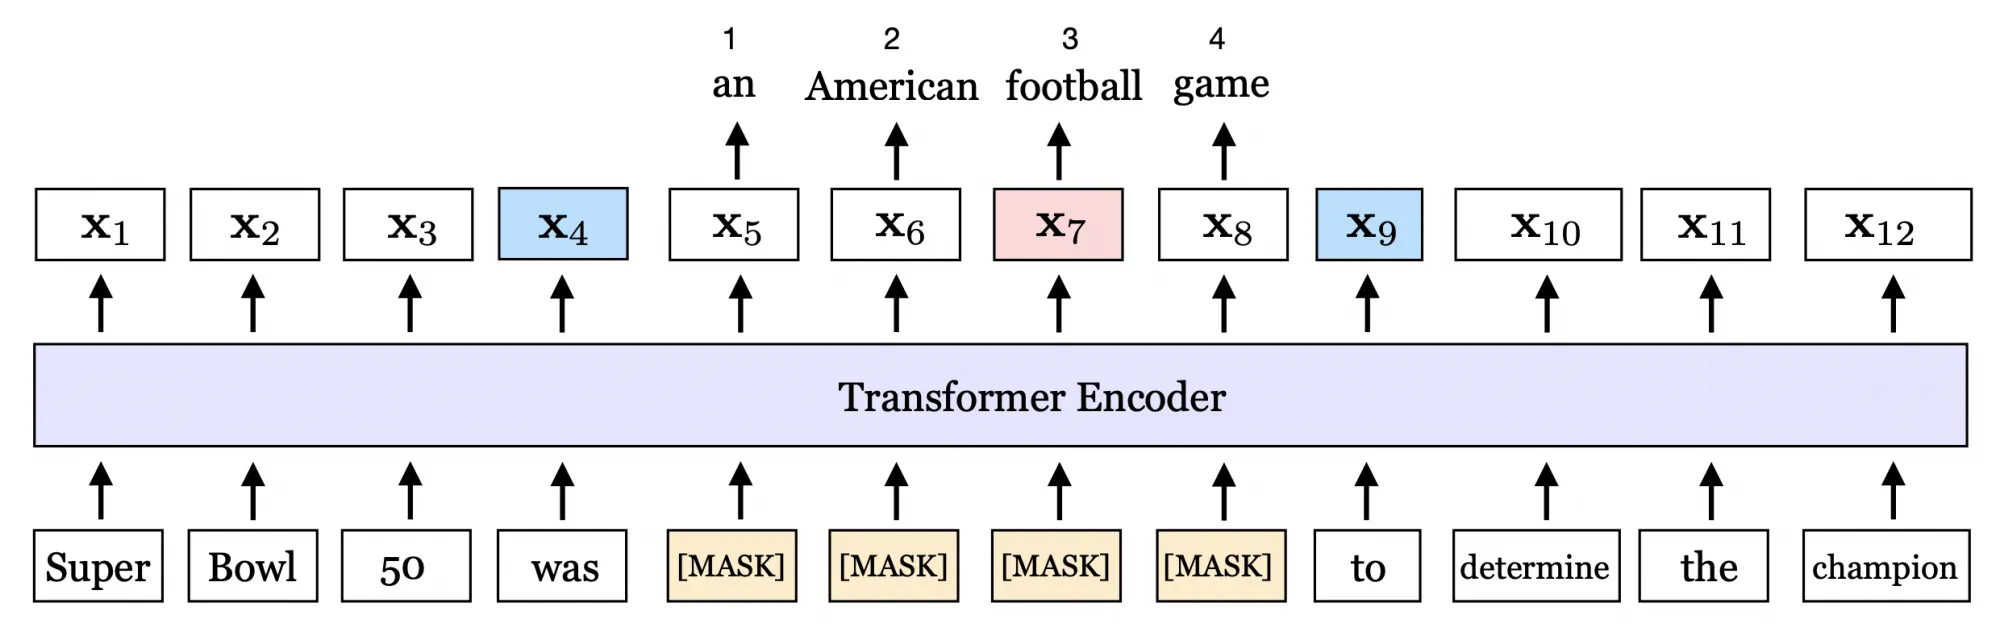
从上图能看到,SpanBERT 训练时先把输入序列随机做一段连续掩码,比如:
输入:Super Bowl 50 was an American football game to determine the champion
掩码:随机挑出输入序列里的 an American football game 这一段做掩码
我们要预测被遮住的 [MASK] 还原成 football。训练时,football 的预测损失由两部分组成,公式如下:
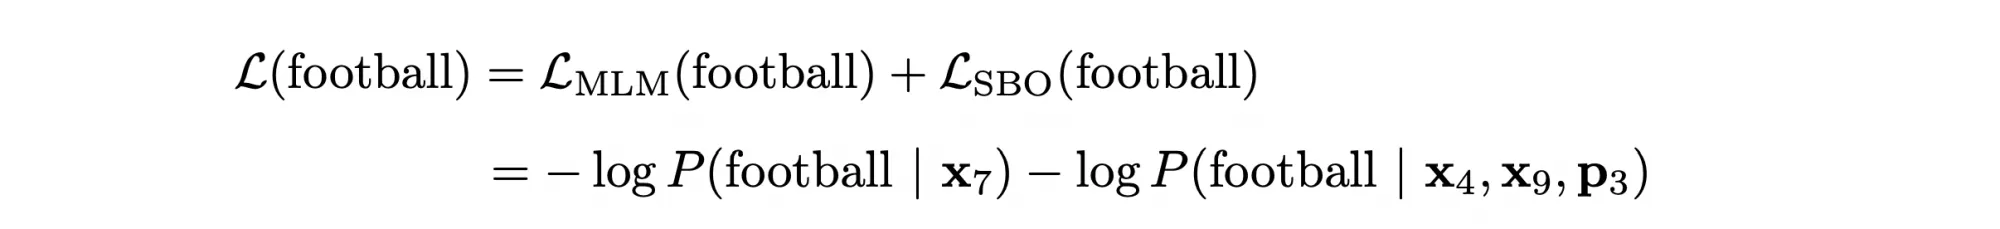
- 第一部分,把 x7(对应 football)的编码 R7(编码器输出向量)送进分类层,得到预测值,再和真实值算交叉熵损失。
- 第二部分,把 x7 对应的位置编码向量,连同区间边界两个 token 的编码器输出一起送进分类层,算预测值与真实值的交叉熵损失。这里的边界 token 指 span 两侧的词,比如上图边界两侧是 was 和 to,记成 x4 和 x9,对应的编码器输出是 R4 和 R9。再提醒一次:这部分损失用的是 x7 的位置编码 p7,不是它的编码 R7。
SpanBERT 训练时的优化目标,就是把这个总损失降下来,从而得到一个在问答(QA)、关系抽取(RE)任务上表现优秀的模型。
上面的 GitHub 仓库提供了两个 SpanBERT 英文预训练模型:
- SpanBERT (base & cased): 12-layer, 768-hidden, 12-heads , 110M parameters
- SpanBERT (large & cased): 24-layer, 1024-hidden, 16-heads, 340M parameters
用下面的命令把模型拉下来:
git clone https://huggingface.co/SpanBERT/spanbert-base-cased
git clone https://huggingface.co/SpanBERT/spanbert-large-cased
 冀公网安备13050302001966号