


在自然语言处理(NLP)任务里,怎么自动评估文本生成的质量,一直是个核心问题。比如机器翻译、自动摘要、文本生成这类任务,我们都需要度量生成文本和参考文本之间的相似度。Rouge(Recall-Oriented Understudy for Gisting Evaluation)就是一种常用的文本评估指标,特别适合用来评摘要生成的质量。
Rouge 主要衡量生成文本和参考文本之间的 n-gram 匹配情况,常见的变体有 Rouge-N、Rouge-L、Rouge-W 和 Rouge-SU 等。
- Rouge-N:计算 n-gram(n 个连续词)的匹配情况,最常用的是 Rouge-1 和 Rouge-2。
- Rouge-L:基于最长公共子序列(LCS),用来衡量顺序上的相似度。
- Rouge-W:是 Rouge-L 的加权版本,对较长的连续匹配赋予更高权重。
- Rouge-SU:计算 Skip-Bigram(跳跃二元组)的匹配,同时引入单字 unigram。
pip install rouge
1. Rouge-N
Rouge-N 是 ROUGE 评测方法中的一种,主要用在 自动摘要、机器翻译、文本生成 等任务。它衡量生成文本(候选文本)和参考文本(标准答案)之间的 N-gram 重叠率,也就是算两者的 相似度。
N-gram 是 NLP 里的一个概念,指由 连续 N 个词(或字符)组成的片段。例如文本 ["我", "是", "中国", "人"]
- 1-gram(Unigram):以每个单独的词为单位,
["我", "是", "中国", "人"] - 2-gram(Bigram):以两个连续的词为单位,
["我是", "是中国", "中国人"] - 3-gram(Trigram):以三个连续的词为单位,
["我是中国", "是中国人"]
Rouge-N 算的就是 参考文本和生成文本之间的 N-gram 重叠率。
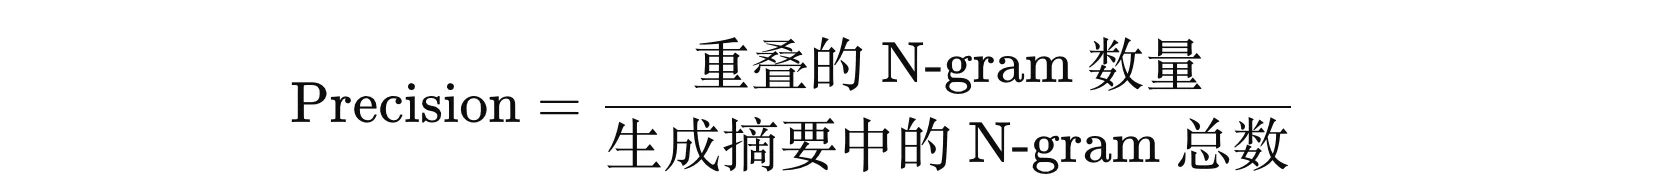
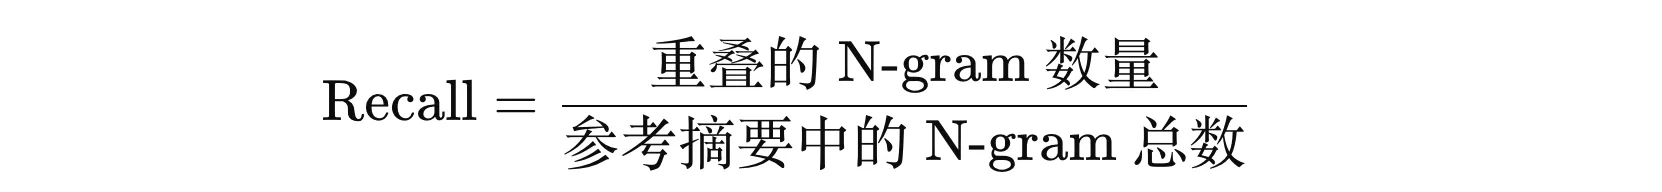
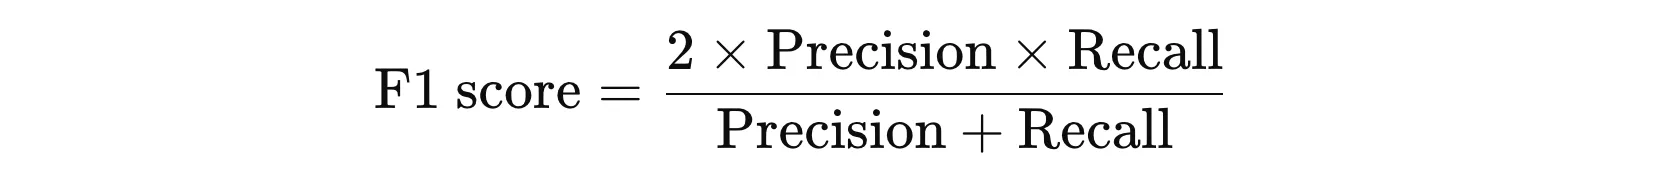
假设我们拿到的生成文本和参考文本如下:
- 机器摘要(Hypothesis):
"我是中国人" - 标准摘要(Reference):
"我是个地地道道堂堂正正的中国人"
对文本做分词(基于 Jieba)
- 机器摘要(Hyp):
["我", "是", "中国", "人"] - 标准摘要(Ref):
["我", "是", "个", "地地道道", "堂堂正正", "的", "中国", "人"]
先做 1-gram 的统计:
- 匹配内容:
["我", "是", "中国", "人"] - 机器摘要:
["我", "是", "中国", "人"] - 标准摘要:
["我", "是", "个", "地地道道", "堂堂正正", "的", "中国", "人"]
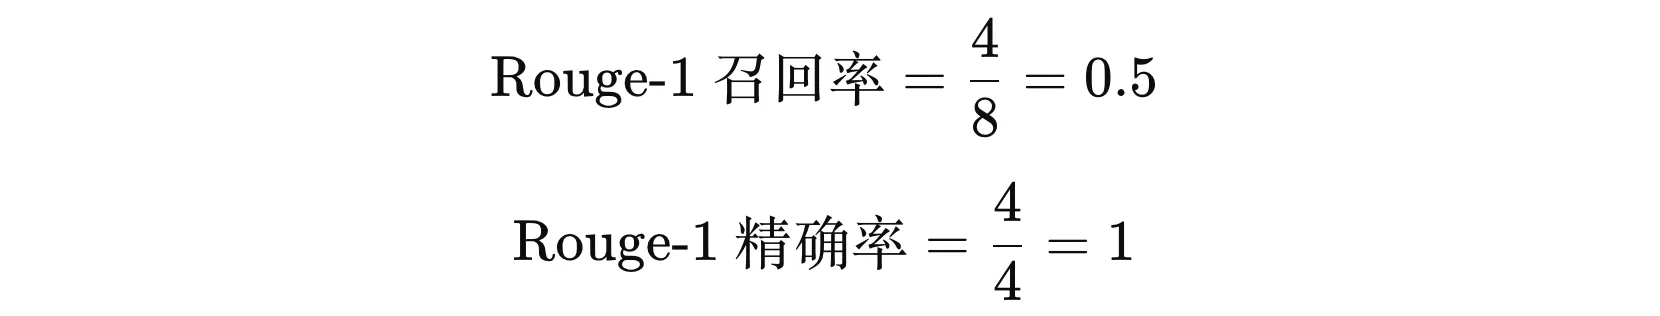
再做 2-gram 的统计:
- 匹配内容:
["我是", "中国人"] - 机器摘要:
["我是", "是中国", "中国人"] - 标准摘要:
["我是", "是个", "个地地道道", "地地道道堂堂正正", "堂堂正正的", "的中国", "中国人"]
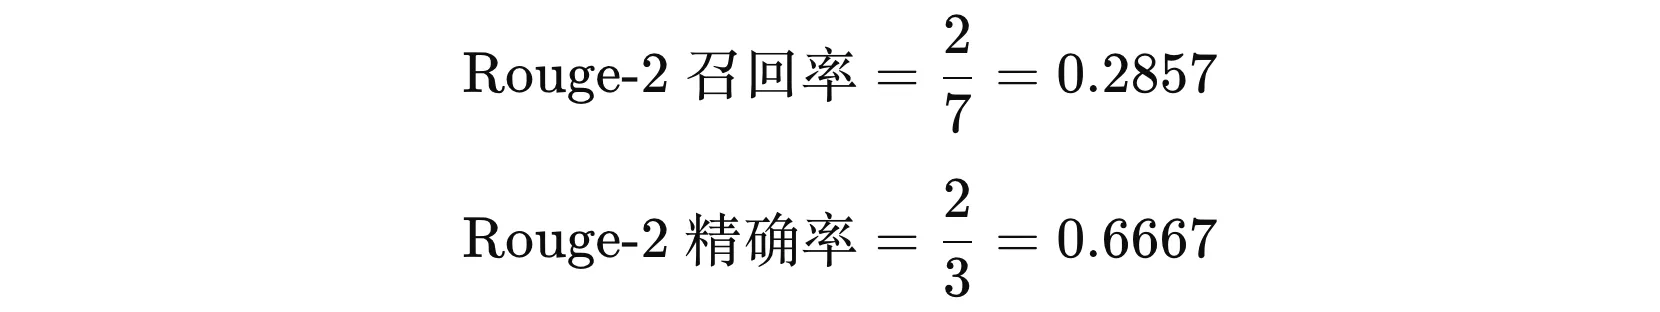
从这个例子能看出来,Rouge-N 是一个关注 Recall 的自动摘要评估指标。
注意:用 Rouge-N 评估前,应该先把停用词去掉。
示例代码:
import rouge
import jieba
import pandas as pd


def test01():
    my_rouge = rouge.Rouge(metrics=["rouge-1", "rouge-2"], stats=["r", 'p'])
    # hyps: 生成摘要
    # refs: 参考摘要
    hyp = jieba.lcut('我是中国人')
    ref = jieba.lcut('我是个地地道道堂堂正正的中国人')
    print('hyp 分词:', hyp)
    print('ref 分词:', ref)
    scores = my_rouge.get_scores(hyps=[' '.join(hyp)], refs=[' '.join(ref)])
    print(scores)

if __name__ == '__main__':
    test01()
[{'rouge-1': {'r': 0.5, 'p': 1.0}, 'rouge-2': {'r': 0.2857142857, 'p': 0.666666666}}]
前面我们都假设参考摘要只有一条。如果参考摘要有好几条,机器生成的这条摘要 Rouge-N 该怎么算呢?其实就是拿它和每条参考各算一遍,取最高的那个得分作为最终得分。
2. Rouge-L
Rouge-L 也是 ROUGE 评测方法中的一种,同样用在自动摘要、机器翻译、文本生成等任务。它靠计算生成文本和参考文本之间的最长公共子序列(LCS, Longest Common Subsequence)来评估相似度。
最长公共子序列(LCS)是指,给定两个序列(比如两个字符串),从中找出一个最长的子序列,让它在两个序列里都出现,而且元素顺序保持不变。例如:
- A = “ABCBDAB”
- B = “BDCABB”
它们的最长公共子序列是 “BCAB”,因为 “BCAB” 是这两个字符串里都出现过的最长子序列。
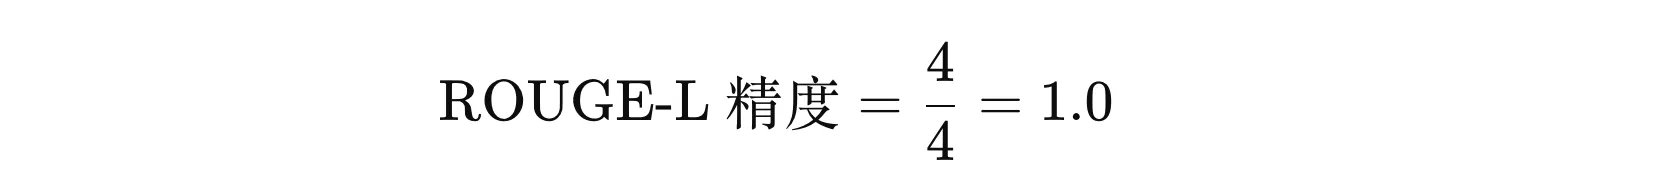
由此能看出,Rouge-L 关注的是词序上的匹配,而不只是词有没有共现。具体做法是用 LCS 的长度来算召回率和精确率,再通过 F1 分数综合评估生成文本和参考文本的相似度。
这个方法的好处是能捕捉句子级别的词序信息,不需要预先指定 N-gram 的长度。它的局限也很明显,只算一条最长子序列,忽略了其他可能子序列的贡献。
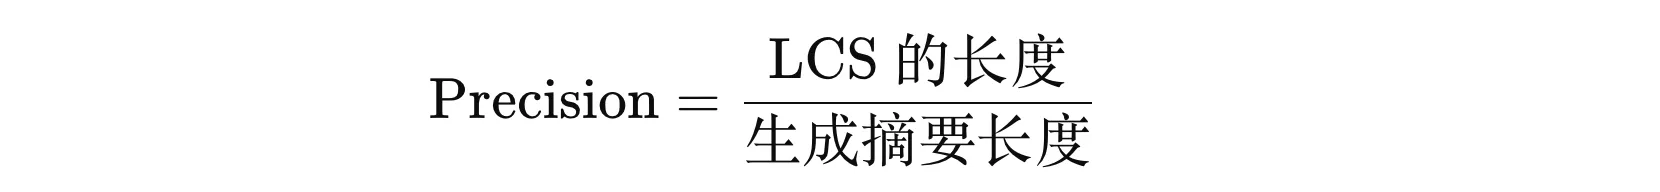
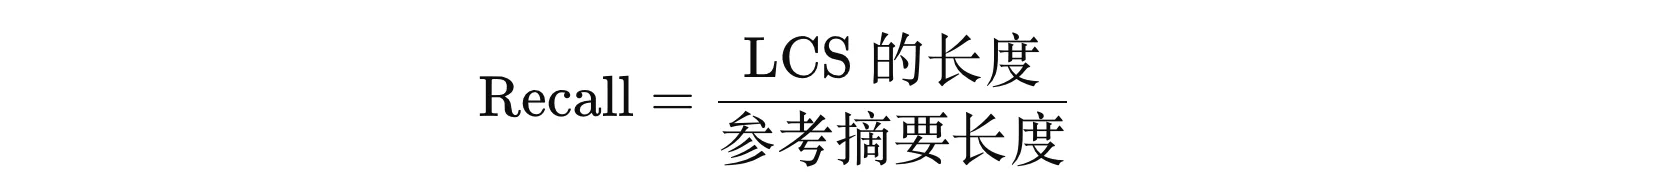
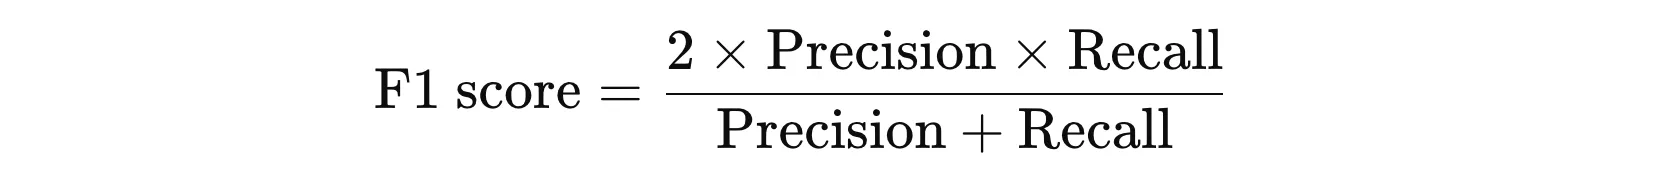
先做 1-gram 的统计:
- LCS内容:
["我", "是", "中国", "人"] - 机器摘要:
["我", "是", "中国", "人"] - 标准摘要:
["我", "是", "个", "地地道道", "堂堂正正", "的", "中国", "人"]

from rouge import Rouge
import jieba
import logging
jieba.setLogLevel(logging.CRITICAL)


def demo():

    rouge = Rouge(metrics=['rouge-l'], stats=['r', 'p'])

    hyps = [' '.join(jieba.lcut('我是中国人'))]
    refs = [' '.join(jieba.lcut('我是一个地地道道堂堂正正的中国人'))]

    scores = rouge.get_scores(hyps=hyps, refs=refs, avg=False)
    print(scores)


if __name__ == '__main__':
    demo()
程序执行结果:
[{'rouge-l': {'r': 0.5, 'p': 1.0}}]
3. 其他 Rouge 变体
Rouge 系列里,除了上面两个,还有 Rouge-W、Rouge-S、Rouge-SU 等,但大多数 rouge 的实现里都没包含它们。原因大致是:
- 它们比基本的 Rouge-N、Rouge-L 更复杂,计算开销更大。
- Rouge-N(尤其是 Rouge-1 和 Rouge-2)已经能覆盖大部分评估需求。
- 这些指标在某些场景下可能确实更有优势,但并不是文本生成任务通用的评估标准。
- Rouge-N 是最常见、接受度最高的评估方式,更复杂的 Rouge 指标在实现上往往不一致,也难标准化,所以没被广泛采用。
从实践经验看,Rouge-1、Rouge-L 在非常短的摘要里表现更好,比如标题级别。Rouge-2、Rouge-L 在单文档摘要上表现很不错。
 冀公网安备13050302001966号