


前面讲过,AdaGrad、RMSProp 是从学习率入手优化的,让不同参数分量用上各自更合适的学习率。Momentum 则是从梯度入手优化,用来避免遇到鞍点、局部最小值时参数卡住不动。
我们常说,Adam 就是把 Momentum 和 RMSProp 的优点合到了一起,即一种梯度和学习率两边都做了优化的梯度下降法。
1. 算法思想理解
Adam 的计算过程如下:
先初始化一个 t 变量,它记录当前进行到第几个 step。为什么要记步数呢?因为一阶动量和二阶动量都是用移动平均算的,移动平均一开始有估计偏差,需要做偏差修正,而修正就要用到这个 t。
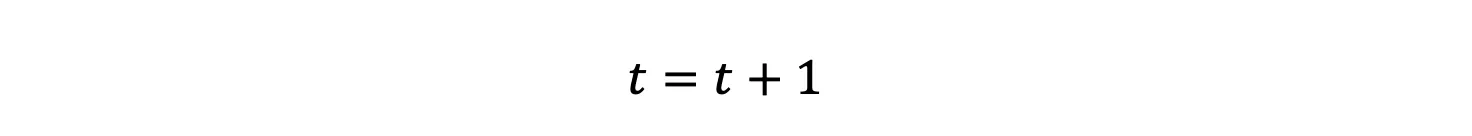
接着,我们对一个 batch 的样本算梯度,注意这里的梯度是多个分量的向量。后面的所有计算都要靠它来推。
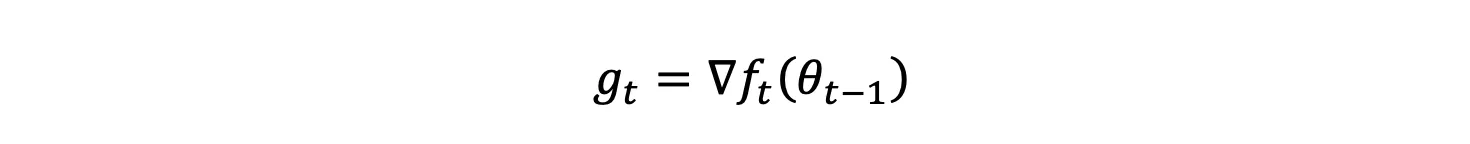
再往下,我们开始累积一阶动量和二阶动量(平方),并对它们做偏差修正。下面公式里,\(m_t\) 是直接用移动平均算出的一阶动量,\(\hat{m}_t\) 是修正后的一阶动量,\(v_t\) 是累积的二阶动量,同理 \(\hat{v}_t\) 是修正后的二阶动量。
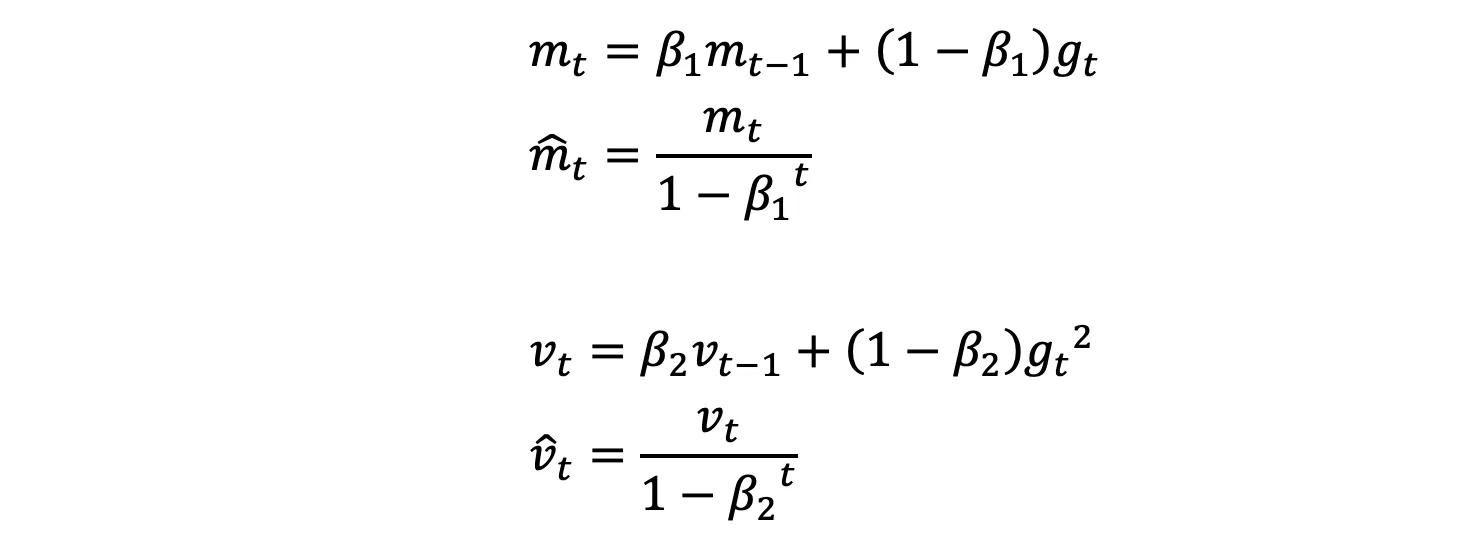
最后说参数更新。前面讲过 Adam 结合了 RMSProp 和 Momentum 的优点,这一点从下面的更新公式就能看出来。
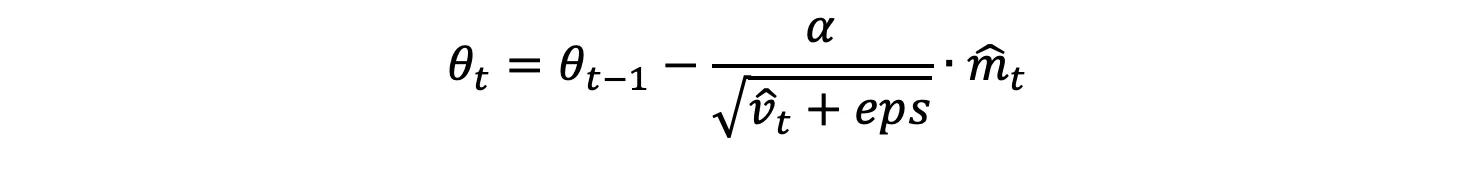
还可以注意到,一阶动量越大,沿某个方向的更新幅度就越大,反之就越小。二阶动量则管学习率,它的值越大,学习率就压得越小。把公式换个写法,还能从另一个角度理解它:
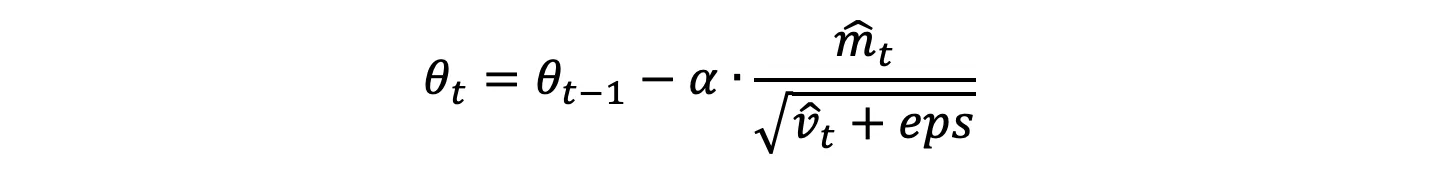
分子是历史梯度的均值估计,分母是历史梯度的方差,也就是历史梯度的离散程度估计。均值除以方差,相当于从整段历史里梯度的变化情况,去估计当前该往哪个方向优化。即参考历史梯度的走势,来指导现在往哪走。因为用的是移动平均,本质上是立足当前和过去、对下一步走向的一种合理估计,有助于加快收敛。
2. PyTorch 源码实现
def adam(params: List[Tensor],
         grads: List[Tensor],
         exp_avgs: List[Tensor],
         exp_avg_sqs: List[Tensor],
         max_exp_avg_sqs: List[Tensor],
         state_steps: List[int],
         *,
         amsgrad: bool,
         beta1: float,
         beta2: float,
         lr: float,
         weight_decay: float,
         eps: float):

    for i, param in enumerate(params):

        # 获得当前参数的梯度
        grad = grads[i]
        # 获得上一个时刻累积的一阶动量
        exp_avg = exp_avgs[i]
        # 获得上一个时刻累积的二阶动量
        exp_avg_sq = exp_avg_sqs[i]
        # 获得当前的时刻表示 t
        step = state_steps[i]

        # 用于后面对一阶、二阶动量的偏差修正
        bias_correction1 = 1 - beta1 ** step
        bias_correction2 = 1 - beta2 ** step

        if weight_decay != 0:
            grad = grad.add(param, alpha=weight_decay)

        # 累计当前的梯度值到一阶动量中
        exp_avg.mul_(beta1).add_(grad, alpha=1 - beta1)
        # 累计当前的梯度值到二阶动量中
        exp_avg_sq.mul_(beta2).addcmul_(grad, grad, value=1 - beta2)
        if amsgrad:
            # Maintains the maximum of all 2nd moment running avg. till now
            torch.maximum(max_exp_avg_sqs[i], exp_avg_sq, out=max_exp_avg_sqs[i])
            # Use the max. for normalizing running avg. of gradient
            denom = (max_exp_avg_sqs[i].sqrt() / math.sqrt(bias_correction2)).add_(eps)
        else:
            # 对二阶动量进行偏差修正,并开根号
            denom = (exp_avg_sq.sqrt() / math.sqrt(bias_correction2)).add_(eps)

        # 下面两行可以看做:-lr * exp_avg/ bias_correction1 / denom
        # exp_avg/ bias_correction1 表示对一阶动量的偏差修正
        # -lr / denom 可以看做通过二阶动量来调整学习率
        step_size = lr / bias_correction1
        param.addcdiv_(exp_avg, denom, value=-step_size)
3. PyTorch 计算演示
- 初始参数:1
- 梯度值:2
- 学习率:0.1
- 动量调节系数:β1 = 0.9,β2 = 0.8,β1 对应的是一阶动量,β2 对应的是二阶动量
- 小常数 EPS = 1e-8
import torch
import torch.optim as optim


if __name__ == '__main__':

    # 构造初始参数
    param = torch.tensor([1], dtype=torch.float32)
    # 设置梯度值
    param.grad = torch.tensor([2], dtype=torch.float32)
    # 使用 Adam 优化器
    optimizer = optim.Adam([param], lr=0.1, eps=1e-8, betas=(0.9, 0.8))

    # 第一次累计梯度平方
    optimizer.step()
    print(optimizer.state)

    # 第二次累计梯度平方
    optimizer.step()
    print(optimizer.state)

    # 第三次累计梯度平方
    optimizer.step()
    print(optimizer.state)
代码里 Adam 的 betas,第一项相当于 Momentum 的调节系数,第二项相当于 RMSProp 累计梯度时的调节系数。程序运行结果如下:
defaultdict(<class 'dict'>, {tensor([0.9000]): {'step': 1, 'exp_avg': tensor([0.2000]), 'exp_avg_sq': tensor([0.8000])}})
defaultdict(<class 'dict'>, {tensor([0.8000]): {'step': 2, 'exp_avg': tensor([0.3800]), 'exp_avg_sq': tensor([1.4400])}})
defaultdict(<class 'dict'>, {tensor([0.7000]): {'step': 3, 'exp_avg': tensor([0.5420]), 'exp_avg_sq': tensor([1.9520])}})
大家可以拿前面的公式手算一遍,就能对上上面程序的输出。
 冀公网安备13050302001966号