


我们在用梯度下降法的时候应该发现了一件事:不同参数分量在更新时,用的是同一个学习率。要注意,不同分量算出来的梯度其实是不一样的。举个例子,我们现在有参数向量 \((x_1, x_2, x_3)\),它有 3 个分量,用梯度下降更新时却共用同一个学习率 lr。
AdaGrad 的核心思想就是:给不同分量配不同的学习率。即更新分量 \(x_1\) 时用 \(lr_1\),更新分量 \(x_2\) 时用 \(lr_2\),两个学习率可以不一样。
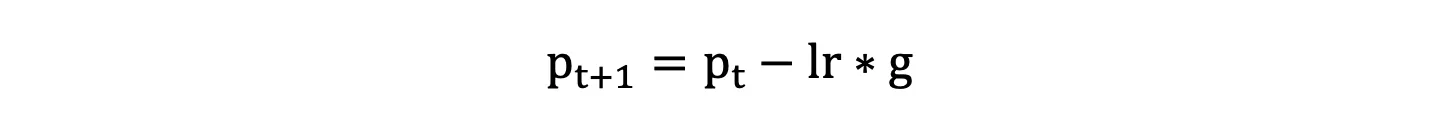
一句话区分:Momentum 是从梯度的角度去优化,AdaGrad 则是从学习率的角度去优化。
1. AdaGrad 方法
AdaGrad 是如何计算出不同分量的梯度?
它的计算步骤如下:
- 初始化学习率 α、初始化参数 θ、小常数 σ = 1e-6
- 初始化梯度累积变量 s = 0
- 从训练集中采样 m 个样本的小批量,计算梯度 g
- 累积平方梯度 s = s + g ⊙ g,⊙ 表示各个分量相乘
- 学习率 α 的计算公式如下:
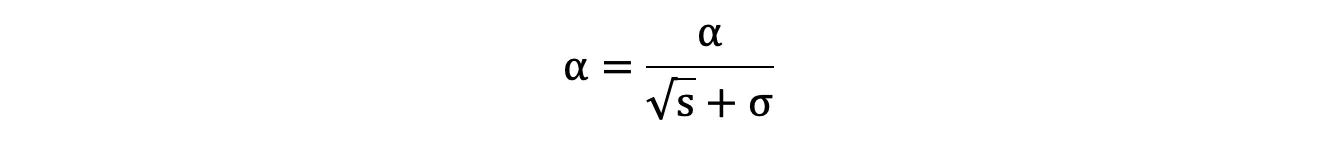
接下来我们举个计算例子:
- 参数初值为 [1]。
- 梯度值为:[2]。
- 学习率为 0.1。
- 小常数为:1e-10
我们用 PyTorch 跑一下,看看每一次迭代累计的平方梯度是多少:
import torch
import torch.optim as optim
import numpy as np


if __name__ == '__main__':

    # 构造初始参数
    param = torch.tensor([1], dtype=torch.float32)
    # 设置梯度值
    param.grad = torch.tensor([2], dtype=torch.float32)
    # 使用 AdaGrad 优化器
    optimizer = optim.Adagrad([param], lr=0.1, eps=1e-10)

    # 第一次累计梯度平方
    optimizer.step()
    print(optimizer.state)

    # 第二次累计梯度平方
    optimizer.step()
    print(optimizer.state)

    # 第三次累计梯度平方
    optimizer.step()
    print(optimizer.state)
程序的输出结果是:
defaultdict(<class 'dict'>, {tensor([0.9000]): {'step': 1, 'sum': tensor([4.])}})
defaultdict(<class 'dict'>, {tensor([0.8293]): {'step': 2, 'sum': tensor([8.])}})
defaultdict(<class 'dict'>, {tensor([0.7716]): {'step': 3, 'sum': tensor([12.])}})
可以看到,s 的累计过程和公式完全对得上。第一次 s = 2 ** 2 = 4,第二次 s = 4 + 2 ** 2 = 8,第三次 s = 8 + 2 ** 2 = 12。
对应的学习率就可以套上面的公式算出来:
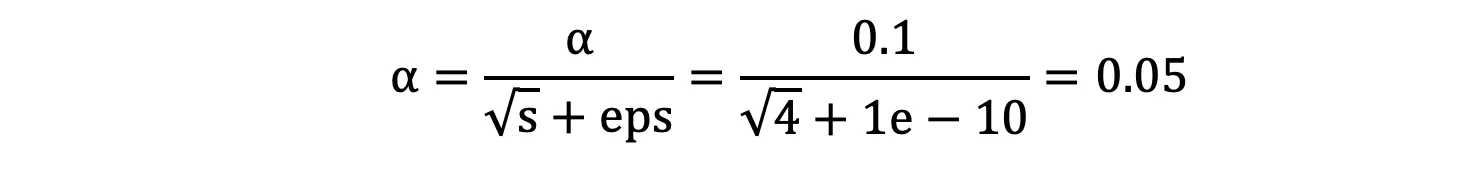
学习率拿到之后,再代入梯度下降公式,就能算出更新后的参数,如下图:
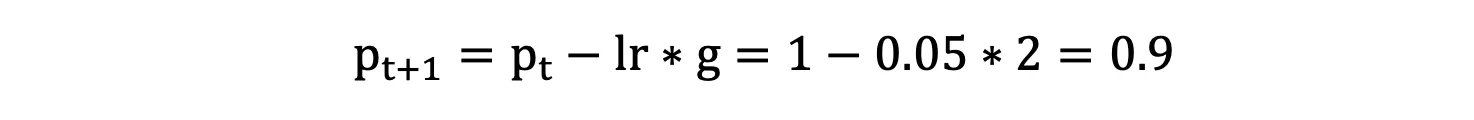
结果和程序跑出来的完全一致。后面的 step 也是同样的套路,先算学习率,再代梯度下降公式即可。
2. RMSProp 方法
AdaGrad 的缺点?
算下来我们会发现,随着 step 增加,累计的平方梯度会越来越大,也就是分母膨胀得太快。到了训练后期,学习率可能过早、过猛地缩水。学习率太小之后,参数基本就更新不动了,模型名义上还在学,实际上已经学不到新东西。
问题出在哪呢?就出在累加平方梯度这个做法太粗暴。RMSProp 正是冲着这一点改的,它用移动加权平均来代替直接累加平方,这样累计出来的梯度会平滑得多。
要注意,RMSProp 本质上就是 AdaGrad 的改进版,而且只改了累计梯度这一处。
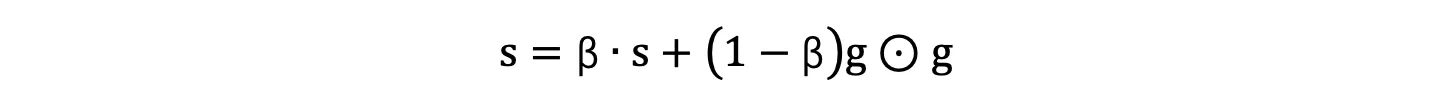
上面公式里的圈点,表示对应分量取平方。我们还沿用刚才那组初始参数来算一遍:
- 参数初值为 [1]。
- 梯度值为:[2]。
- 学习率为 0.1。
- 小常数为:1e-8
- β平滑系数值为:0.9
第一次累计的梯度值是:(1-0.9) * 2 ** 2 = 0.4。第二次累计为:0.9 * 0.4 + (1-0.9) * 2**2 = 0.36 + 0.4 = 0.76。第三次累计为:0.9 * 0.76 + (1-0.9) * 2 ** 2 = 1.084。
于是第一次得到的学习率是:0.1 / (np.sqrt(0.4) + 1e-8) = 0.15811,更新后的参数为:1 – 0.15811 * 2 = 0.68378。
示例程序如下:
import torch
import torch.optim as optim
import numpy as np


if __name__ == '__main__':

    # 构造初始参数
    param = torch.tensor([1], dtype=torch.float32)
    # 设置梯度值
    param.grad = torch.tensor([2], dtype=torch.float32)
    # 使用 RMSProp 优化器,alpha 对应的就是 β 值
    optimizer = optim.RMSprop([param], lr=0.1, eps=1e-8, alpha=0.9)

    # 第一次累计梯度平方
    optimizer.step()
    print(optimizer.state)

    # 第二次累计梯度平方
    optimizer.step()
    print(optimizer.state)

    # 第三次累计梯度平方
    optimizer.step()
    print(optimizer.state)
程序运行结果:
defaultdict(<class 'dict'>, {tensor([0.6838]): {'step': 1, 'square_avg': tensor([0.4000])}})
defaultdict(<class 'dict'>, {tensor([0.4544]): {'step': 2, 'square_avg': tensor([0.7600])}})
defaultdict(<class 'dict'>, {tensor([0.2623]): {'step': 3, 'square_avg': tensor([1.0840])}})
RMSProp 靠引入衰减系数 β,来控制历史梯度在累计中占多大分量。实践证明,它在神经网络这种非凸问题上优化得更好,学习率的衰减也更合理。
需要注意一点:AdaGrad 和 RMSProp 都是给不同参数分量配不同的学习率。某个分量梯度大,对应的学习率就压得小,某个分量梯度小,对应的学习率就放得大。
无论是 AdaGrad 还是 RMSProp,学习率都依赖历史累计的梯度。所以经过很多 step 之后,累计值越滚越大,学习率整体呈下降趋势。这其实正符合我们的预期:一开始离最优点还远,可以用大一点的学习率加快训练,随着迭代推进,学习率再慢慢降下来。
 冀公网安备13050302001966号