


KL 散度是一种衡量两个概率分布之间差异的度量。它描述的是,用一个概率分布去近似另一个概率分布时带来的信息损失。在信息论里,KL 散度也叫相对熵。
我们假设 \( P(x) \)、\( Q(x) \) 是随机变量 \( x \) 的两个概率分布。离散和连续两种情形下,KL 散度的计算公式如下:
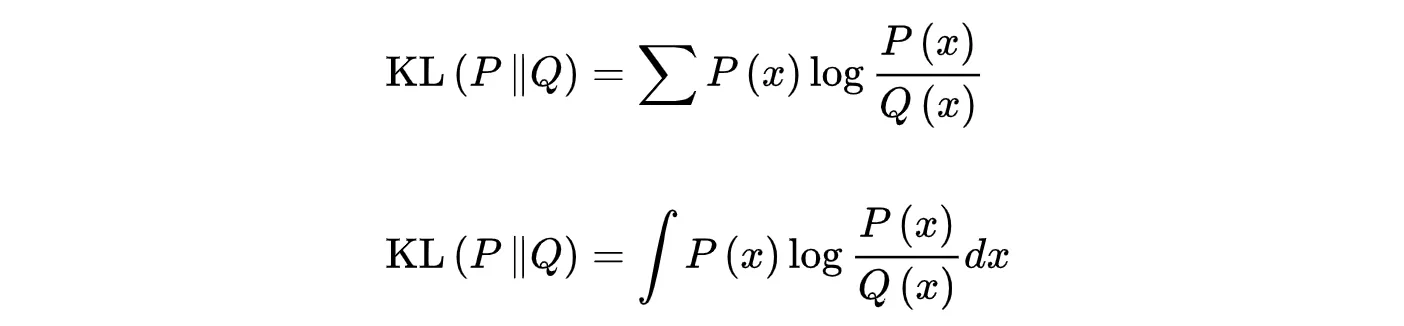
我们可以把 P(x) 看成随机变量 x 的理论分布,把 Q(x) 看成实际场景中观测到的分布。KL 散度的作用,就是量化实际分布离理论分布到底有多远:这个值越小,说明两者越接近,值越大就越远。当且仅当 P=Q 时,KL 值等于 0。
举个例子。假设有一台字符发射器,随机发出 0 和 1 两种字符。我们只知道这两个值理论上应该服从分布 A(0:0.5, 1:0.5),但实际做实验时并不知道 A 到底是不是这个分布。
我们做两组实验,分别观测到分布 B 和 C。三个分布的具体数值如下:
- A(0) = 1/2,A(1) = 1/2
- B(0) = 1/4,B(1) = 3/4
- C(0) = 1/8,C(1) = 7/8
接下来套用上面的公式,算一算实验得到的 B、C 离理论分布 A 有多远,也就是求 B、C 相对于 A 的 KL 散度。
import numpy as np


if __name__ == '__main__':

    A0, A1 = 1/2, 1/2
    B0, B1 = 1/4, 3/4
    C0, C1 = 1/8, 7/8

    KL_A_B = A0*np.log(A0/B0) + A1*np.log(A1/B1)
    print(KL_A_B)

    KL_A_C = A0 * np.log(A0 / C0) + A1 * np.log(A1 / C1)
    print(KL_A_C)
程序的输出结果是:
0.14384103622589042
0.4133392865922339
从结果看,KL(A||B) 比 KL(A||C) 小,说明实验得到的 B 分布相对理论分布的信息损耗更少,也就是 B 比 C 更接近理论分布 A。
 冀公网安备13050302001966号