


1. pad_sequence
我们先看 pad_sequence 函数。同一个 batch 里的序列长度往往不一样,pad_sequence 会用 0 把它们补齐到最长那条序列的长度,如下图所示:
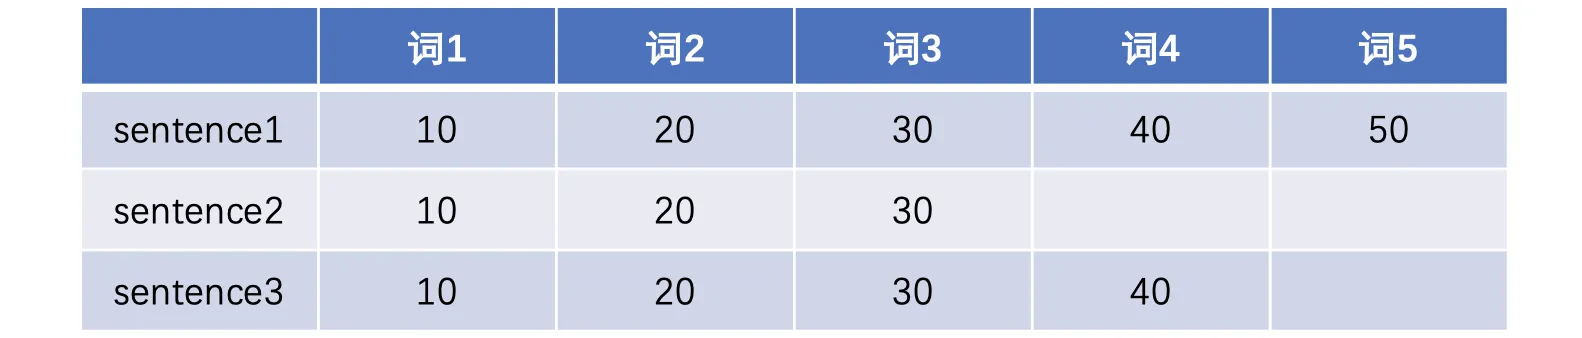
上图里有 3 个句子,我们用数字代表某个词或字。第一条序列长度是 5,第二条是 3,第三条是 4。用 pad_sequence 补 0 之后,结果如下图:
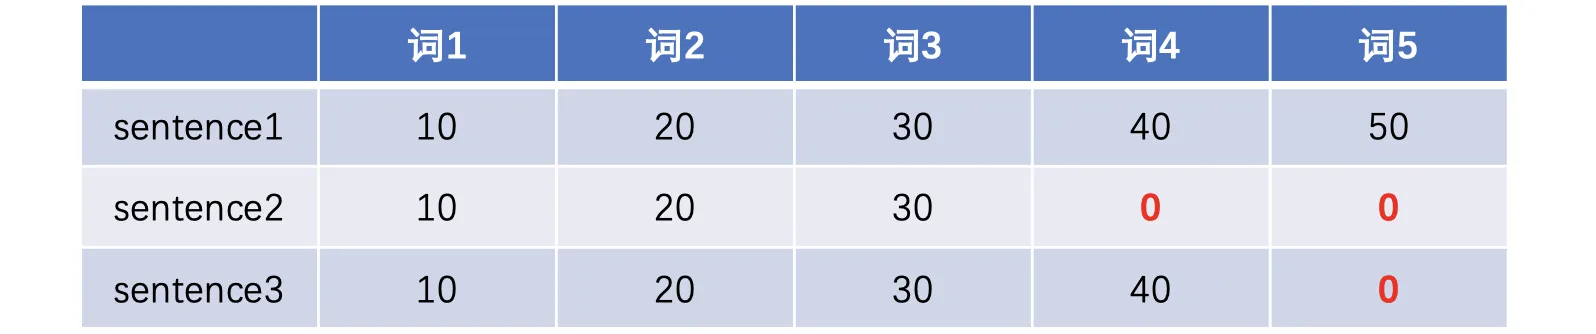
函数的使用代码如下:
import torch
import torch.nn as nn
from torch.nn.utils.rnn import pad_sequence


def test():

    # 1.1 填充一维张量
    a = torch.tensor([10, 20, 30, 40, 50])
    b = torch.tensor([10, 20, 30])
    c = torch.tensor([10, 20, 30, 40])

    # 将三个张量放在列表中,传入到 pad_sequence 函数中
    data = pad_sequence([a, b, c], batch_first=True)
    print(data)

    # 1.2 填充二维张量
    a = torch.randn(2, 3)
    b = torch.randn(4, 3)
    c = torch.randn(3, 3)

    data = pad_sequence([a, b, c], batch_first=True)
    print(data)


if __name__ == '__main__':
    test()
程序输出结果:
tensor([[10, 20, 30, 40, 50],
        [10, 20, 30,  0,  0],
        [10, 20, 30, 40,  0]])
tensor([[[ 1.1548,  0.0590,  1.2352],
         [ 1.1051,  0.3413, -1.4559],
         [ 0.0000,  0.0000,  0.0000],
         [ 0.0000,  0.0000,  0.0000]],

        [[-1.3324, -0.8635,  1.3135],
         [ 0.5169, -0.8685, -2.8555],
         [-0.0589,  0.0805,  1.1203],
         [ 0.4198,  0.8386, -0.0064]],

        [[-0.2444, -0.8604, -0.3829],
         [-0.9048, -1.3597, -1.8759],
         [ 0.4579, -0.7069, -0.5881],
         [ 0.0000,  0.0000,  0.0000]]])
2. pack_sequence 函数
再看 pack_sequence。它会把同一个 batch 里长度不一的序列,打包成一个 PackedSequence 对象来处理。这里要注意,pack_sequence 要求把不同的 tensor 放进一个列表,并且按长度从长到短排好序。
示例代码如下:
import torch
import torch.nn as nn
from torch.nn.utils.rnn import pack_sequence


def test():

    # 1.1 填充一维张量
    a = torch.tensor([10, 20, 30, 40, 50])
    b = torch.tensor([10, 20, 30])
    c = torch.tensor([10, 20, 30, 40])

    # 先把 [a, b, c] 按照长度从大到小
    sort_data = sorted([a, b, c], key=lambda x: len(x), reverse=True)
    # 构建压缩后的表示
    data = pack_sequence(sort_data)
    print(data)

    # 1.2 填充二维张量
    a = torch.randn(2, 3)
    b = torch.randn(4, 3)
    c = torch.randn(3, 3)

    # 先把 [a, b, c] 按照长度从大到小
    sort_data = sorted([a, b, c], key=lambda x: len(x), reverse=True)
    # 构建压缩后的表示,输入形状 [L, *]
    data = pack_sequence(sort_data)
    print(data)


if __name__ == '__main__':
    test()
程序输出结果:
PackedSequence(data=tensor([10, 10, 10, 20, 20, 20, 30, 30, 30, 40, 40, 50]), batch_sizes=tensor([3, 3, 3, 2, 1]), sorted_indices=None, unsorted_indices=None)
PackedSequence(data=tensor([[-0.4226,  0.1640, -1.4525],
        [-0.6334, -0.4643, -0.2134],
        [-1.3638, -0.5982, -0.3764],
        [-0.2297, -1.4002, -0.0083],
        [ 1.7213,  0.5896, -0.6520],
        [-0.4708,  1.6265,  1.0932],
        [ 1.9799,  0.2921,  0.7135],
        [ 1.5097, -0.5596, -0.3654],
        [-0.7631,  1.5645, -1.2764]]), batch_sizes=tensor([3, 3, 2, 1]), sorted_indices=None, unsorted_indices=None)
- PackedSequence 里的 data 表示压缩后的数据
- batch_sizes 表示每个时间步有多少条数据。例如 [3, 3, 3, 2, 1],第一个 3 表示 data 里 [10, 10, 10, 20, 20, 20, 30, 30, 30, 40, 40, 50] 的前 3 个数字是第一个时间步的输入,接着第二个 3 的那 3 个数字,就是第二个时间步的输入。
PyTorch 里的 RNN、LSTM、GRU 都支持直接吃 PackedSequence 类型的数据。
3. 二者区别
import torch
import torch.nn as nn
from torch.nn.utils.rnn import pad_sequence
from torch.nn.utils.rnn import pack_sequence
from torch.nn.utils.rnn import pack_padded_sequence


# 固定随机数种子
torch.manual_seed(0)


# 1. 使用 pad_sequence
def test01():

    inputs = [torch.tensor([10, 20, 30, 40, 50]),
              torch.tensor([10, 20, 30]),
              torch.tensor([10, 20, 30, 40])]

    # 使用 pad_sequence 对 batch 数据长度处理
    inputs = pad_sequence(inputs)
    # print(inputs.shape)

    # 经过词嵌入层
    embed = nn.Embedding(num_embeddings=100, embedding_dim=2)
    inputs = embed(inputs)
    # print(inputs.shape)

    gru = nn.GRU(input_size=2, hidden_size=4)
    # GRP 输入形状: [sentence_length, batch_size, input_size]
    output, h = gru(inputs)
    print(h.data)


# 2. 使用 pack_padded_sequence
def test02():

    inputs = [torch.tensor([10, 20, 30, 40, 50]),
              torch.tensor([10, 20, 30]),
              torch.tensor([10, 20, 30, 40])]

    # 先对 inputs 根据长度排序
    inputs.sort(key=lambda x: len(x), reverse=True)

    # 先对输入序列进行0填充
    inputs = pad_sequence(inputs)

    # 经过词嵌入层,由于很多0经过,词嵌入之后也有很多0
    embed = nn.Embedding(num_embeddings=100, embedding_dim=2, padding_idx=0)
    inputs = embed(inputs)
    # print(inputs.shape)
    # print(inputs.transpose(0, 1))

    # 接下来通过 pack_padded_sequence 对输入进行压缩
    inputs = pack_padded_sequence(inputs, lengths=[5, 4, 3])
    # print(inputs)

    gru = nn.GRU(input_size=2, hidden_size=4)
    # GRP 输入形状: [sentence_length, batch_size, input_size]
    output, h = gru(inputs)
    print(h.data)


if __name__ == '__main__':
    test01()
    print('-' * 50)
    test02()
程序输出结果:
tensor([[[ 0.0466, -0.4807, -0.0078, -0.0605],
         [-0.0605, -0.3388,  0.1844, -0.2294],
         [ 0.0828, -0.3468,  0.0599, -0.2231]]])
--------------------------------------------------
tensor([[[-0.2108,  0.3736,  0.0056, -0.4251],
         [-0.0305,  0.0509, -0.1880, -0.6150],
         [ 0.4270, -0.0893,  0.0460, -0.5448]]])
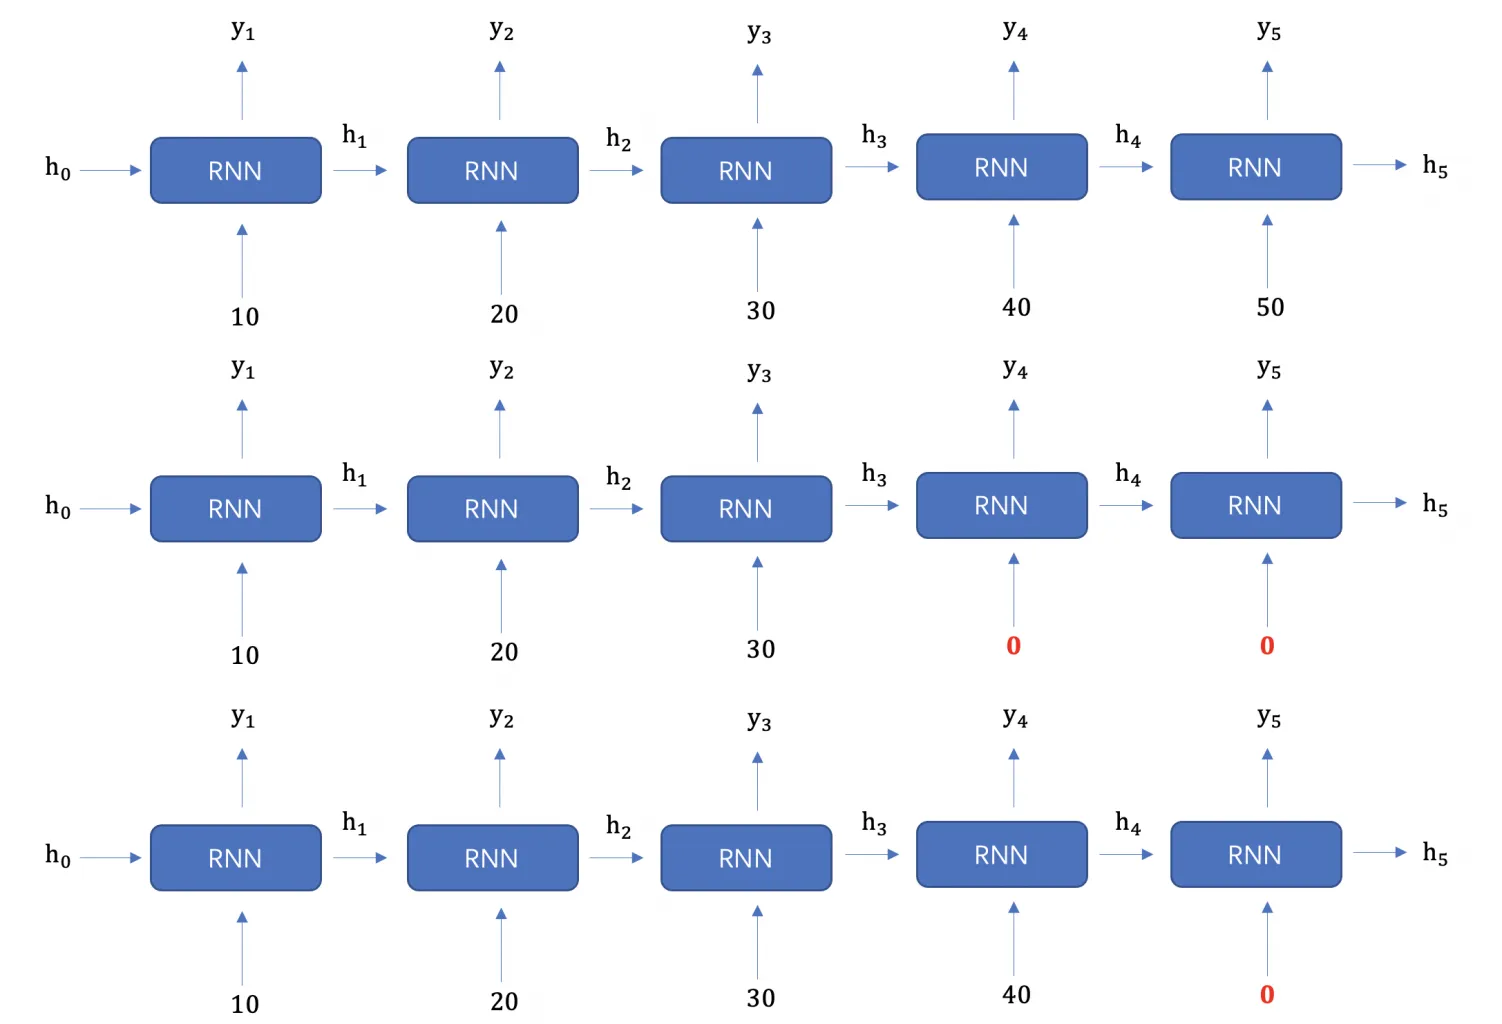
上面这段代码里,test01 和 test02 都是先用 pad_sequence 把数据补 0 到相同长度,再经过 Embedding 转成词嵌入。
区别就在后面这一步。test01 直接把词嵌入结果送进 GRU 做序列信息提取,过程如下图:
test02 则是先把词嵌入结果用 pack_padded_sequence 压缩一下,再送进 GRU,过程如下:
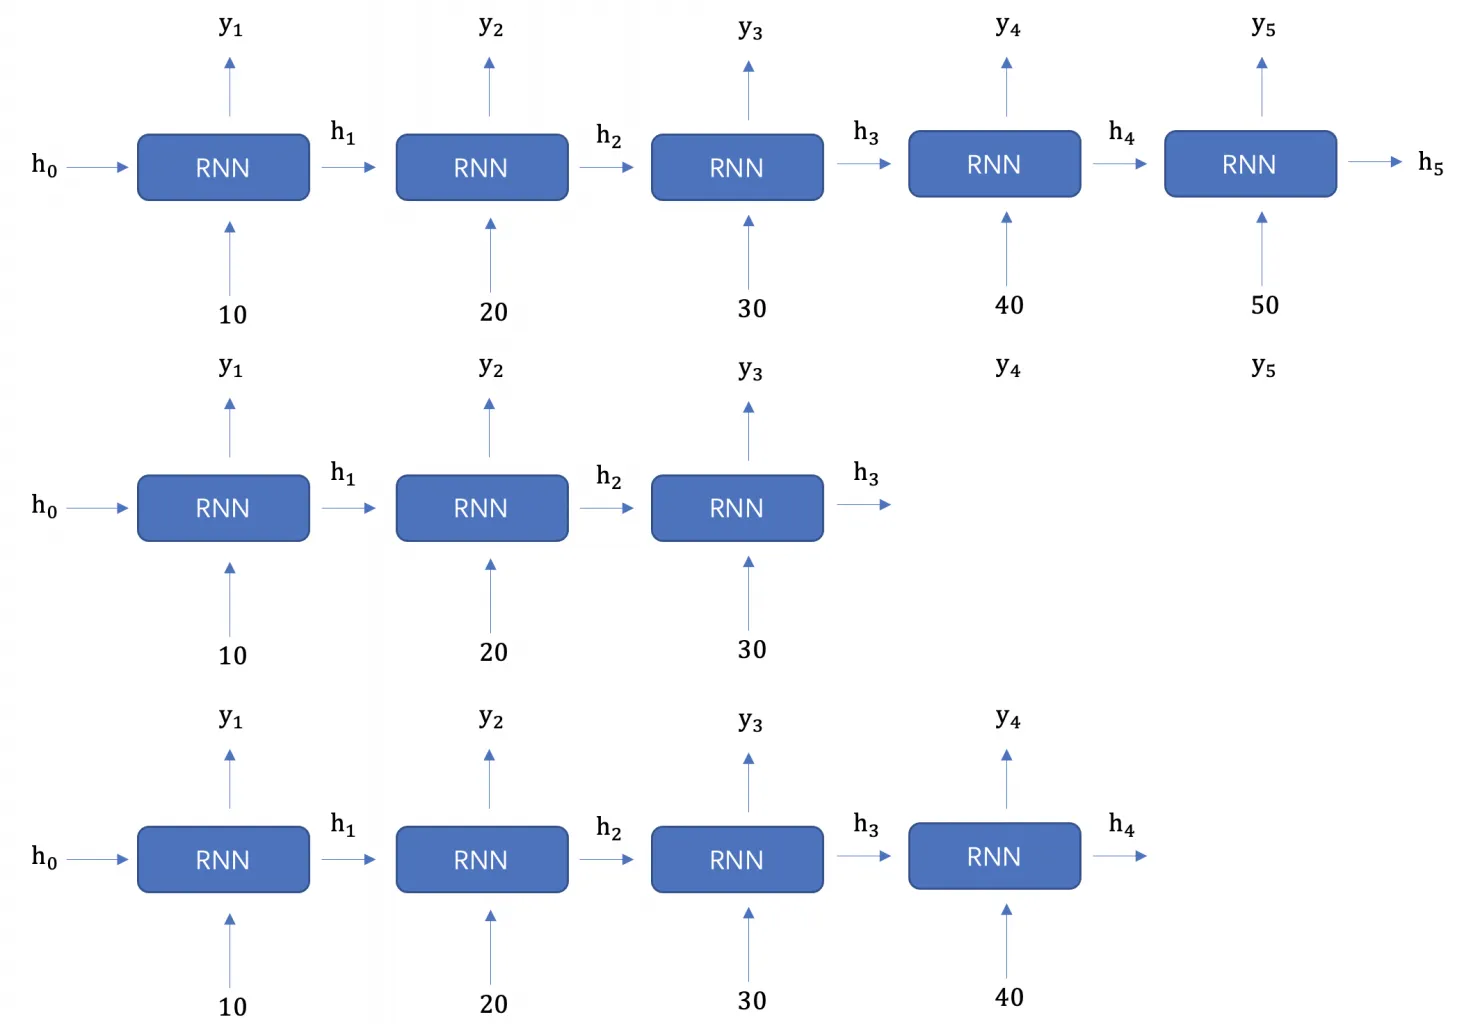
说白了,用 pack_padded_sequence 这种方式,就不用把一大堆补出来的 0 送进循环网络白算一遍,省掉那些没有意义的计算。
4. pad_sequences 函数
pad_sequences 函数可以把文本截断、填充到指定长度。
from keras_preprocessing.sequence import pad_sequences
sentence_content = pad_sequences(sentence_content, maxlen=100, padding='post')
 冀公网安备13050302001966号