


批量归一化(Batch Normalization,BN)主要解决的是内部协变量偏移(Internal Covariate Shift)问题。这个问题说的是,深度神经网络在训练过程中,每一层的输入分布会随着前面层参数的更新而不断变化,结果就是训练不稳定、收敛速度变慢。
具体是怎么回事呢?每层的输入分布随着训练不断变化,网络里的每一层就得不停去适应这个新分布。这样一来,训练就不稳定了,参数更新幅度忽大忽小,而且要花更多时间才能适应这些变化,收敛自然就慢了。
BN 的做法,是对每一层的输入做标准化,让它的均值接近 0、方差接近 1,这样就把输入分布的变化压下去了。每一层的输入分布一旦稳定下来,训练过程也就跟着稳定了。
1. BN 计算公式
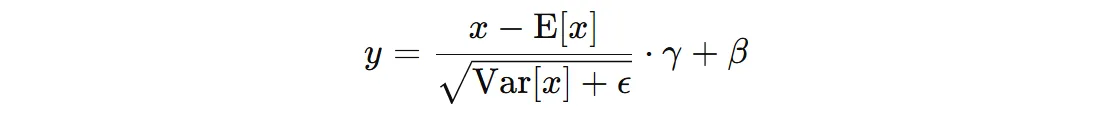
- \( x \) 表示输入数据,训练时它是一个批次的样本
- \( E[x] \) 表示输入数据 \( x \) 的均值
- \( Var(x) \) 表示输入数据 \( x \) 的方差
- \( \epsilon \) 是一个小常数 1e-5,用来避免分母为零
- \( \gamma \) 是可学习的参数,用来控制标准化后数据的尺度,它会通过反向传播不断更新
- \( \beta \) 也是可学习的参数,用来控制标准化后数据的平移,也就是调整数据的均值,同样通过反向传播更新
经过 BN,输入数据的分布先被调整成均值为 0、方差为 1,然后再用 \( \gamma、\beta \) 这两个参数对分布做进一步调整。这样网络就能根据数据本身的特性去适应不同的输入分布,学得更合适,训练更稳,收敛也更快。
在 CNN 里,BN 常接在卷积层后面,用来加速训练、稳定网络的学习,处理复杂图像数据时尤其管用。接在全连接层后面用 BN,也能明显改善训练速度,缓解训练过程中的梯度问题。
还有一点要注意,BN 一般放在激活函数之前用,即:先对卷积层、线性层的输出做 BN,再送进激活函数。为什么呢?激活函数的作用是引入非线性,让网络能学到复杂的模式。如果把 BN 放在激活函数之后,就等于在已经非线性的输出上再做标准化,这可能破坏网络的表达能力和非线性特性,反而影响学习。
2. BN 使用示例
PyTorch 里给了三种 BN 实现,分别对应不同的输入形状,常用的是下面这两种:
torch.nn.BatchNorm1d(num_features, eps=1e-5, momentum=0.1, affine=False, track_running_stats=True)
torch.nn.BatchNorm2d(num_features, eps=1e-5, momentum=0.1, affine=False, track_running_stats=True)
- num_features:对于
(batch_size, input_dim)这种普通批次数据,它对应input_dim。而对于(batch_size, channels, height, width)这种图像批次数据,它对应的是channels。 - affine:如果设为
True,这一层就会有两个可训练参数gamma和beta。如果设为False,这一层就没有这些参数,直接用标准化后的输出。 - track_running_stats:如果设为
True,训练期间 BN 会边算边维护当前批次均值和方差的滑动平均,留给推理(评估)阶段用。如果设为False,就不统计这些信息。 - momentum:用来更新
BN里running_mean和running_var的系数。
running_mean 和 running_var 的更新公式:
running_mean = (1 - momentum) * running_mean + momentum * batch_mean
running_var  = (1 - momentum) * running_var  + momentum * batch_var
注意,BN 实际用时要分训练模式和推理模式两种(track_running_stats=True):
- 训练模式:会一边累计均值和方差的滑动平均,一边用当前批次的 batch_mean 和 batch_var 来算输出
- 推理模式:不再累计滑动平均,计算时直接用 running_mean 和 running_var
下面我们看这两个 API 的使用示例:
import torch
import torch.nn as nn


def test01():
    bn = nn.BatchNorm1d(num_features=5, eps=1e-5, momentum=0.1, affine=False, track_running_stats=True)
    bn.train()

    # 数据形状 (batch_size, input_dim)
    data = torch.rand(size=(10, 5))
    data = torch.split(data, 5)

    for batch_inputs in data:
        outputs = bn(batch_inputs)
        print('均值:', bn.running_mean, '方差:', bn.running_var)

    # 推理时,会使用累计的均值和方差进行计算
    bn.eval()
    output = bn(torch.rand(size=(1, 5)))
    print(output)


def test02():
    bn = nn.BatchNorm2d(num_features=3, eps=1e-5, momentum=0.1, affine=False, track_running_stats=True)
    bn.train()

    # 数据形状 (batch_size, channels, height, width)
    data = torch.rand(size=(6, 3, 2, 2))
    data = torch.split(data, 2)

    for batch_inputs in data:
        outputs = bn(batch_inputs)
        print('均值:', bn.running_mean, '方差:', bn.running_var)

    bn.eval()
    output = bn(torch.rand(size=(1, 3, 2, 2)))
    print(output)


if __name__ == '__main__':
    test01()
    print('-' * 30)
    test02()
程序执行结果:
均值: tensor([0.0571, 0.0544, 0.0531, 0.0600, 0.0437]) 方差: tensor([0.9009, 0.9079, 0.9060, 0.9097, 0.9031])
均值: tensor([0.0950, 0.1010, 0.0722, 0.1169, 0.0945]) 方差: tensor([0.8237, 0.8247, 0.8245, 0.8306, 0.8159])
tensor([[-0.0235,  0.3534,  0.7883,  0.0882,  1.0016]])
------------------------------
均值: tensor([0.0486, 0.0496, 0.0545]) 方差: tensor([0.9096, 0.9051, 0.9135])
均值: tensor([0.1084, 0.0850, 0.1127]) 方差: tensor([0.8259, 0.8194, 0.8302])
均值: tensor([0.1290, 0.1263, 0.1426]) 方差: tensor([0.7495, 0.7419, 0.7561])
tensor([[[[ 0.7845,  1.0046],
          [ 0.3233,  0.4021]],

         [[ 0.0600,  0.4899],
          [-0.0521, -0.0421]],

         [[ 0.8965,  0.7647],
          [ 0.1038,  0.8081]]]])
最后再补充一点,这两种不同形状的数据,它们的批次均值和方差是怎么算的:
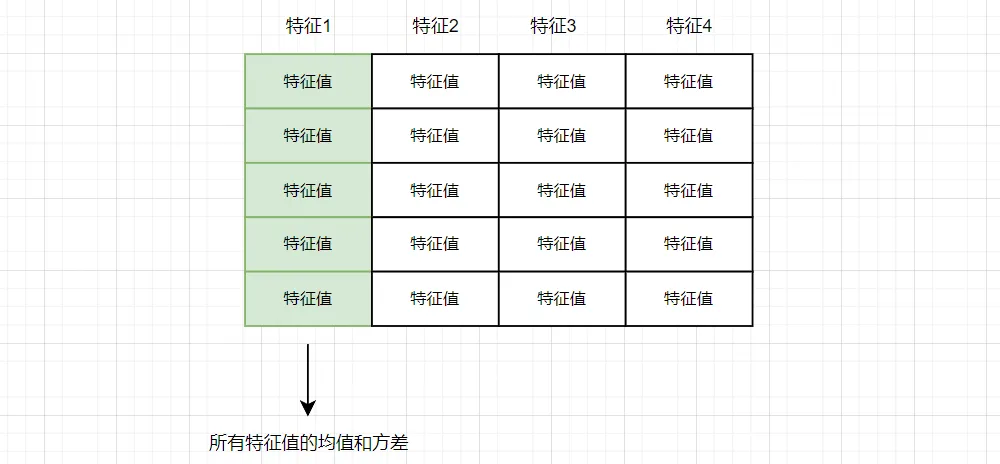
对于 (batch_size, input_dim) 形状的数据,均值和方差是以特征为单位算的。也就是把这个批次里、某个特征对应的所有值当成一组,来算这个特征在本批次的均值和方差。
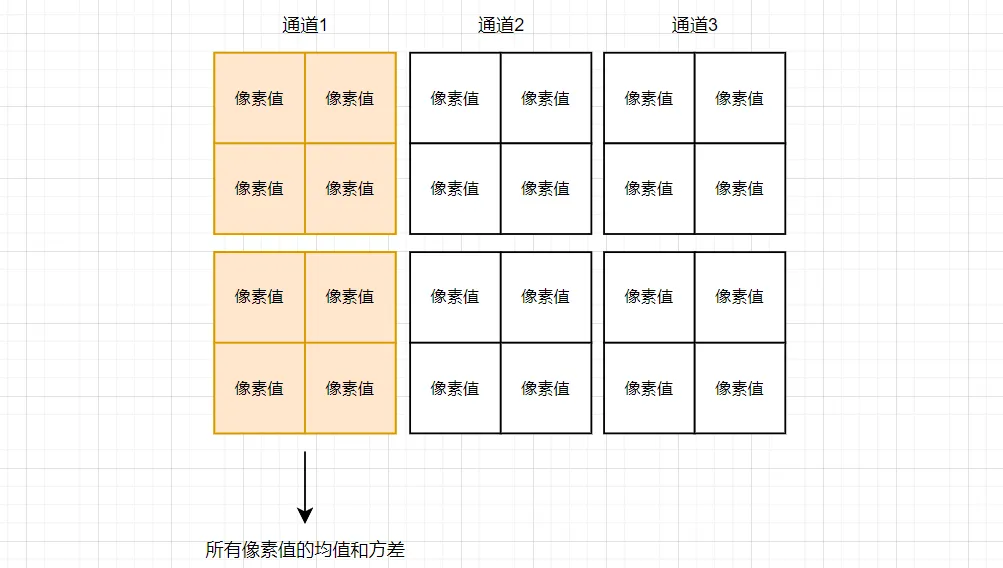
对于 (batch_size, channels, height, width) 形状的数据,均值和方差是以通道为单位算的。也就是把一个批次里、某个通道下所有特征图的所有像素值当成一组 (像素值, 像素值... 像素值),来算这个通道在本批次的均值和方差。
 冀公网安备13050302001966号