


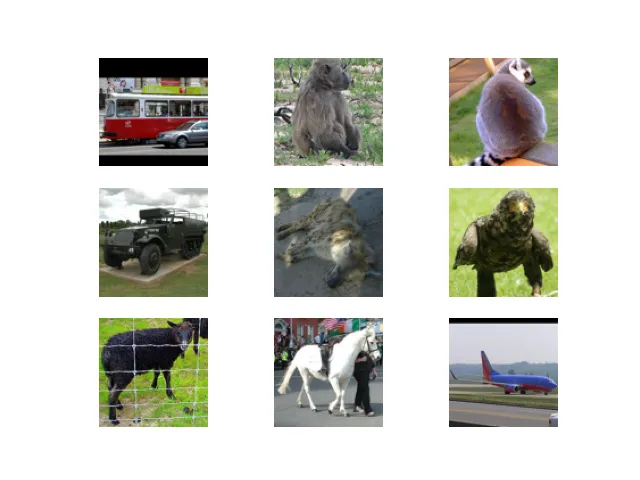
STL-10 是一个用于图像识别和生成任务的数据集,训练集 5000 张图,测试集 8000 张,另外还有 100000 张无标签图像,适合做无监督和半监督学习。图像尺寸是 96×96,正好拿来当生成模型的训练数据。我们这次把全部 113000 张图都用上,来训练一个 GAN 网络。
生成对抗网络(GAN,Generative Adversarial Networks)是一种基于博弈论的深度学习模型,由 生成器(Generator) 和 判别器(Discriminator) 两部分组成。我们往生成器里喂随机噪声,它就能生成和真实数据相像的图像,判别器则负责分辨输入是生成图还是真实图,再通过反向传播不断把生成器 G 的能力往上推。
1. 数据处理
我们先建一个 custom_dataset.py 文件,代码如下:
import torch
from torch.utils.data import Dataset
from torchvision import transforms
import numpy as np
import matplotlib.pyplot as plt


class CustomDataset(Dataset):

    def __init__(self):
        with open('stl10_binary/train_X.bin', 'rb') as f:
            numpy_images = np.fromfile(f, dtype=np.uint8)
            data1 = numpy_images.reshape(-1, 3, 96, 96).transpose(0, 3, 2, 1)

        with open('stl10_binary/test_X.bin', 'rb') as f:
            numpy_images = np.fromfile(f, dtype=np.uint8)
            data2 = numpy_images.reshape(-1, 3, 96, 96).transpose(0, 3, 2, 1)

        with open('stl10_binary/unlabeled_X.bin', 'rb') as f:
            numpy_images = np.fromfile(f, dtype=np.uint8)
            data3 = numpy_images.reshape(-1, 3, 96, 96).transpose(0, 3, 2, 1)

        self.data = merged_array = np.concatenate((data1, data2, data3), axis=0)

        print('数据量:', len(self.data))

        self.transform = transforms.Compose([
            transforms.ToTensor(),
            transforms.Normalize((0.5, 0.5, 0.5), (0.5, 0.5, 0.5))
        ])

    def show(self):
        indices = np.arange(0, len(self.data))
        indexes = np.random.choice(indices, 9)
        for idx, index in enumerate(indexes):
            plt.subplot(3, 3, idx + 1)
            plt.imshow(self.data[index])
            plt.axis('off')
        plt.show()

    def __len__(self):
        return len(self.data)

    def __getitem__(self, idx):
        sample = self.data[idx]
        if self.transform:
            sample = self.transform(sample)
        return sample


if __name__ == '__main__':
    images = CustomDataset()
    images.show()

    # for idx, image in enumerate(images):
    #     print(image.shape, torch.min(image).item(), torch.max(image).item())
数据量: 113000
2. 生成器
再建 generator.py 定义生成器,代码如下:
import torch
import torch.nn as nn


class Generator(nn.Module):
    def __init__(self):
        super(Generator, self).__init__()

        self.model = nn.Sequential(
            # 全连接层,将 256 维的潜在向量映射到更大的空间
            nn.Linear(256, 256 * 6 * 6),
            # 重塑为 (batch_size, 256, 6, 6)
            nn.Unflatten(1, (256, 6, 6)),
            # 转置卷积层,逐步上采样
            nn.ConvTranspose2d(256, 512, kernel_size=4, stride=2, padding=1),
            nn.BatchNorm2d(512),
            nn.LeakyReLU(0.2, inplace=True),

            nn.ConvTranspose2d(512, 256, kernel_size=4, stride=2, padding=1),
            nn.BatchNorm2d(256),
            nn.LeakyReLU(0.2, inplace=True),

            nn.ConvTranspose2d(256, 128, kernel_size=4, stride=2, padding=1),
            nn.BatchNorm2d(128),
            nn.LeakyReLU(0.2, inplace=True),

            nn.ConvTranspose2d(128, 3, kernel_size=4, stride=2, padding=1),
            nn.Tanh()
        )

    def forward(self, x):
        # 输入形状: (batch_size, 256, 1, 1)
        x = x.view(x.size(0), -1)  # 展平为 (batch_size, 256)
        return self.model(x)


if __name__ == '__main__':

    generator = Generator()

    def print_shape(module, input, output):
        print('模块名称:', module)
        print('输入形状:', input[0].shape, '输出形状:', output.shape)
        print('-' * 100)

    for name, module in generator.named_modules():
        if isinstance(module, (nn.ConvTranspose2d)):
            module.register_forward_hook(print_shape)

    latent_vector = torch.randn(2, 256, 1, 1)  # 输入噪声 (batch_size=2, 256, 1, 1)
    output = generator(latent_vector)  # 输出 (batch_size=2, 3, 96, 96)
    print(output.shape)
3. 判别器
接着建 discriminator.py 定义判别器,代码如下:
import torch
import torch.nn as nn


class Generator(nn.Module):
    def __init__(self):
        super(Generator, self).__init__()

        self.model = nn.Sequential(
            # 全连接层,将 256 维的潜在向量映射到更大的空间
            nn.Linear(256, 256 * 6 * 6),
            # 重塑为 (batch_size, 256, 6, 6)
            nn.Unflatten(1, (256, 6, 6)),
            # 转置卷积层,逐步上采样
            nn.ConvTranspose2d(256, 512, kernel_size=4, stride=2, padding=1),
            nn.BatchNorm2d(512),
            nn.LeakyReLU(0.2, inplace=True),

            nn.ConvTranspose2d(512, 256, kernel_size=4, stride=2, padding=1),
            nn.BatchNorm2d(256),
            nn.LeakyReLU(0.2, inplace=True),

            nn.ConvTranspose2d(256, 128, kernel_size=4, stride=2, padding=1),
            nn.BatchNorm2d(128),
            nn.LeakyReLU(0.2, inplace=True),

            nn.ConvTranspose2d(128, 3, kernel_size=4, stride=2, padding=1),
            nn.Tanh()
        )

    def forward(self, x):
        # 输入形状: (batch_size, 256, 1, 1)
        x = x.view(x.size(0), -1)  # 展平为 (batch_size, 256)
        return self.model(x)


if __name__ == '__main__':

    generator = Generator()

    def print_shape(module, input, output):
        print('模块名称:', module)
        print('输入形状:', input[0].shape, '输出形状:', output.shape)
        print('-' * 100)

    for name, module in generator.named_modules():
        if isinstance(module, (nn.ConvTranspose2d)):
            module.register_forward_hook(print_shape)

    latent_vector = torch.randn(2, 256, 1, 1)  # 输入噪声 (batch_size=2, 256, 1, 1)
    output = generator(latent_vector)  # 输出 (batch_size=2, 3, 96, 96)
    print(output.shape)
4. 对抗训练
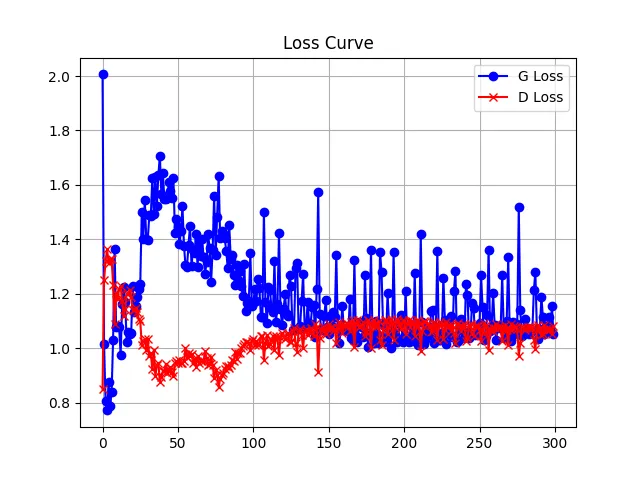
然后建 train.py 开始对抗训练,代码如下。整个训练跑 300 个 epoch,大概要 15 个小时。
import shutil
import warnings
warnings.filterwarnings('ignore')
import torchvision
import torchvision.transforms as transforms
from torch.utils.data import DataLoader
import matplotlib.pyplot as plt
from generator import Generator
from discriminator import Discriminator
import torch
import torch.nn as nn
import torch.optim as optim
import pickle
import os
from tqdm import tqdm
from custom_dataset import CustomDataset


def generate_images(model_id):
    device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
    # 加载图像生成器
    generator = pickle.load(open(f'model/{model_id}/generator.pkl', 'rb')).to(device)
    # 生成图像噪声
    batch_size, noise_dim = 16, 256
    image_noise = torch.randn(batch_size, noise_dim, 1, 1).to(device)
    # 根据噪声生成图像
    with torch.no_grad():
        images = generator(image_noise)
    # 显示生成的图像
    for idx, image in enumerate(images, start=1):
        plt.subplot(4, 4, idx)
        image = image.permute(1, 2, 0).cpu().numpy()
        # 像素映射到 [0, 1]
        image = (image + 1) / 2
        plt.imshow(image)
        plt.axis('off')
    plt.title(f'{model_id}')
    plt.show()


def plot_loss_curve():

    train_G_loss = pickle.load(open(f'model/train_G_loss.pkl', 'rb'))
    train_D_loss = pickle.load(open(f'model/train_D_loss.pkl', 'rb'))
    plt.plot(range(len(train_G_loss)), train_G_loss, label='G Loss', color='blue', marker='o')
    plt.plot(range(len(train_D_loss)), train_D_loss, label='D Loss', color='red', marker='x')
    plt.title('Loss Curve')
    plt.legend()
    plt.grid()
    plt.show()


def train():
    # 1. 数据加载
    dataset = CustomDataset()
    dataloader = DataLoader(dataset, batch_size=128, shuffle=True)

    # 2. 初始化模型
    device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
    generator = Generator().to(device)
    discriminator = Discriminator().to(device)

    # 3. 定义损失函数和优化器
    criterion = nn.BCELoss(reduction='mean')
    optimizer_G = optim.Adam(generator.parameters(), lr=0.00035)
    optimizer_D = optim.Adam(discriminator.parameters(), lr=0.00007)

    # 4. 训练过程
    train_G_loss, train_D_loss = [], []
    for epoch in range(300):
        progress = tqdm(range(len(dataloader)), ncols=100, desc='Epoch:%2d Loss G:%.5f Loss D:%.5f' % (0, 0, 0))
        epoch_G_loss, epoch_D_loss, epoch_size = 0, 0, 0
        for real_images in dataloader:
            # 图像批次大小
            batch_size = real_images.shape[0]

            # ----------------------------------------------------
            # 下面这一部分目的是训练判别器的判别能力
            # ----------------------------------------------------

            # 1. 生成器生成伪造图像和标签(0)
            image_noise = torch.randn(batch_size, 256, 1, 1).to(device)
            fake_images = generator(image_noise)


            fake_labels = torch.zeros(batch_size, 1).to(device)

            # 2. 数据集加载真实图像和标签(1)
            real_images = real_images.to(device)
            real_labels = torch.ones(batch_size, 1).to(device)

            # 3. 判别器对图像伪造概率预测(1表示真实, 0表示伪造)
            # 注意: 这里使用 fake_images 使用 detach
            # 原因: 由于 fake_images 是由 generator 生成,如果不断开,则会更新 generator 的参数,
            # 而此处我们只希望训练判别器,而不是生成器。简言之: 如果不断开,D 训练时,G 也会受到影响

            fake_proba = discriminator(fake_images.detach())
            real_proba = discriminator(real_images)

            # 4. 计算判别器损失(正负样本损失)
            fake_loss = criterion(fake_proba.squeeze(), fake_labels.squeeze())
            real_loss = criterion(real_proba.squeeze(), real_labels.squeeze())
            disc_loss = fake_loss + real_loss

            # 5. 判别器参数更新
            optimizer_D.zero_grad()
            disc_loss.backward()
            optimizer_D.step()

            # ----------------------------------------------------
            # 下面这一部分目的是训练生成器的生成能力,目标是让生成器骗过生成器
            # ----------------------------------------------------

            # 6. 让生成器骗过判别器
            # 前面我们把伪造图像的标签设置为真是标签0,这里设置为假的标签1,目的是为了欺骗判别器
            fake_labels = torch.ones(batch_size, 1).to(device)
            # 7. 计算判别器将伪造图像当做真图像的概率
            # 概率越大,说明判别器越预测错误,被欺骗的程度越高,损失越低
            # 概率越小,说明判别器越预测准确,被欺骗的程度越高,损失越高
            fake_proba = discriminator(fake_images)
            gene_loss = criterion(fake_proba.squeeze(), fake_labels.squeeze())

            # 8. 生成器参数更新
            optimizer_G.zero_grad()
            gene_loss.backward()
            optimizer_G.step()

            # 9. 记录损失变化
            epoch_size += batch_size
            epoch_G_loss += gene_loss.item() * batch_size
            epoch_D_loss += disc_loss.item() * batch_size

            epoch_avg_G_loss = epoch_G_loss / epoch_size
            epoch_avg_D_loss = epoch_D_loss / epoch_size

            progress.set_description('Epoch:%2d Loss G:%.5f Loss D:%.5f' % (epoch + 1, epoch_avg_G_loss, epoch_avg_D_loss))
            progress.update()
        progress.close()

        train_G_loss.append(epoch_avg_G_loss)
        train_D_loss.append(epoch_avg_D_loss)

        # 10. 模型存储
        if (epoch + 1) % 2 == 0:
            save_path = f'model/{epoch + 1}/'
            if os.path.exists(save_path) or os.path.isdir(save_path):
                shutil.rmtree(save_path)
            os.mkdir(save_path)
            pickle.dump(generator, open(save_path + 'generator.pkl', 'wb'))
            pickle.dump(discriminator, open(save_path + 'discriminator.pkl', 'wb'))

            generate_images(epoch + 1)

    # 11. 打印训练损失变化曲线
    pickle.dump(train_G_loss, open('model/train_G_loss.pkl', 'wb'))
    pickle.dump(train_D_loss, open('model/train_D_loss.pkl', 'wb'))
    plot_loss_curve()


# watch -n 10 nvidia-smi
if __name__ == '__main__':
    train()
5. 图像生成
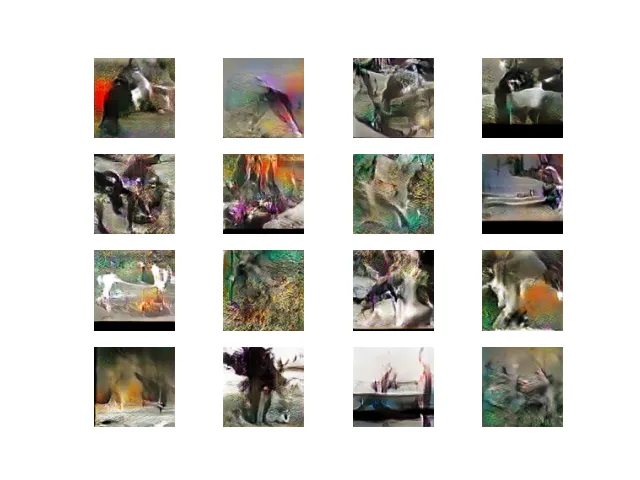
最后建一个 demo.py,加载训练好的生成器出图,代码如下:
import warnings
warnings.filterwarnings('ignore')
from generator import Generator
import pickle
import torch
import matplotlib.pyplot as plt
import os


def generate_images():

    device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
    # 加载图像生成器
    generator = pickle.load(open(f'model/300/generator.pkl', 'rb')).to(device)
    # 生成图像噪声
    batch_size, noise_dim = 16, 256
    image_noise = torch.randn(batch_size, noise_dim, 1, 1).to(device)
    # 根据噪声生成图像
    with torch.no_grad():
        images = generator(image_noise)
    # 显示生成的图像
    for idx, image in enumerate(images, start=1):
        plt.subplot(4, 4, idx)
        image = image.permute(1, 2, 0).cpu()
        # 像素映射到 [0, 1]
        image = (image + 1) / 2
        plt.imshow(image, cmap='gray')
        plt.axis('off')
    plt.show()


if __name__ == '__main__':
    generate_images()
 冀公网安备13050302001966号