


基于类别均值的分类方法(Nearest Mean Classification,NMC)是一种很简单的监督学习算法。它的思路很直接:先算出每个类别样本的均值向量,再把新样本归到和它最相似的那个均值所在的类别。在类别比较集中、特征维度又不高的场景下,这种方法效果还不错。
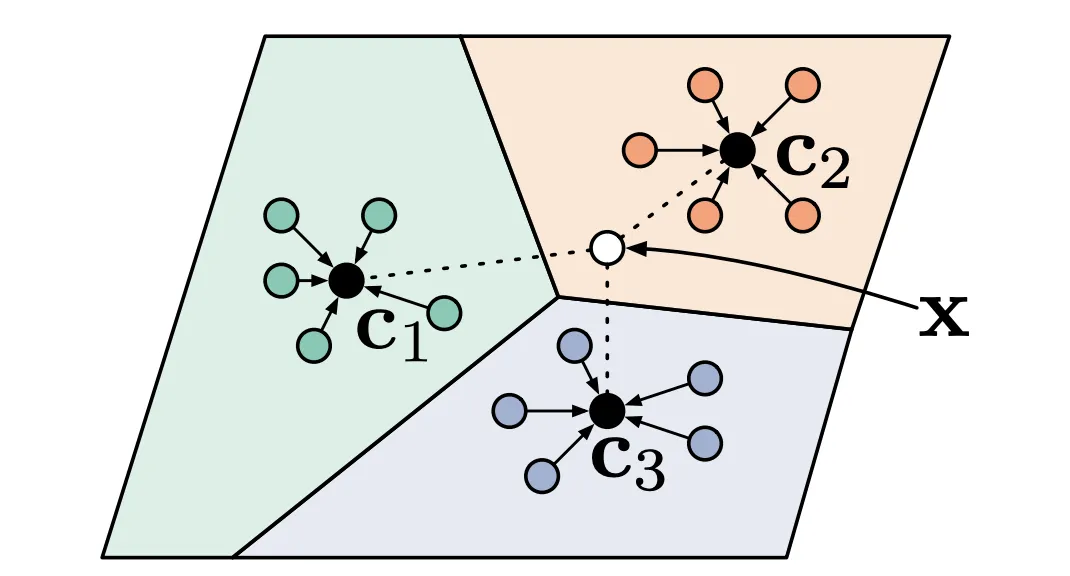
方法简单,自然也有局限。它对类别分布的假设比较强,默认每个类别的样本都围绕均值向量呈球形分布。一旦类别内部的样本分布比较复杂,它就抓不住类别特征,分类效果也就跟着变差。
1. 准备数据
import pickle
from collections import Counter
import glob
import os


def demo():

    fnames = glob.glob('ThuCnews/*.txt')
    for fname in fnames:
        name, ext = os.path.splitext(os.path.basename(fname))
        reports, targets = [], []
        with open(fname) as file:
            for line in file:
                target, report = line.strip().split('\t')
                reports.append((target, report))
                targets.append(target)

            print(name, Counter(targets))
        pickle.dump(reports, open(f'{name}.pkl', 'wb'))


if __name__ == '__main__':
    demo()
test Counter({'体育': 1000, '娱乐': 1000, '家居': 1000, '房产': 1000, '教育': 1000, '时尚': 1000, '时政': 1000, '游戏': 1000, '科技': 1000, '财经': 1000})
valid Counter({'体育': 500, '娱乐': 500, '家居': 500, '房产': 500, '教育': 500, '时尚': 500, '时政': 500, '游戏': 500, '科技': 500, '财经': 500})
train Counter({'体育': 5000, '娱乐': 5000, '家居': 5000, '房产': 5000, '教育': 5000, '时尚': 5000, '时政': 5000, '游戏': 5000, '科技': 5000, '财经': 5000})
2. 类别向量
训练集数量大,算起来比较耗时,所以代码里算类别均值时,用的是验证集那 5000 条样本。
import logging
logging.basicConfig(level=logging.ERROR)
import pickle
import numpy as np
import torch.nn as nn
import torch
from transformers import BertModel
from transformers import BertTokenizer
from transformers import AutoModel
from torch.utils.data import DataLoader
from torch.utils.data import TensorDataset
import tqdm
from collections import defaultdict
from sklearn.metrics import accuracy_score


class SentimentAnalysis(nn.Module):

    def __init__(self):
        super(SentimentAnalysis, self).__init__()
        device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
        print('device:', device)
        self.encoder = AutoModel.from_pretrained('jina-embeddings-v3', trust_remote_code=True).to(device)

    def encode(self, texts):
        embeddings = self.encoder.encode(texts, convert_to_tensor=True, truncate_dim=1024, task='classification')
        return embeddings

    def fit(self, train_data):

        def collate_fn(batch_data):
            batch_targets, batch_reports = [], []
            for target, report in batch_data:
                batch_targets.append(target)
                batch_reports.append(report)
            return batch_targets, batch_reports

        dataloader = DataLoader(train_data, batch_size=2, shuffle=True, collate_fn=collate_fn)
        progress = tqdm.tqdm(range(len(dataloader)), desc='Train')
        class_numbers, class_vectors = {}, {}
        for batch_targets, batch_reports in dataloader:
            with torch.no_grad():
                batch_vectors = self.encode(batch_reports)
            for target, vector in zip(batch_targets, batch_vectors):
                if target not in class_vectors:
                    class_vectors[target] = torch.zeros(1024)
                if target not in class_numbers:
                    class_numbers[target] = 0
                class_vectors[target] += vector.cpu()
                class_numbers[target] += 1
            progress.update()
        progress.close()

        self.targets, self.vectors = [], []
        for class_name, class_number in class_numbers.items():
            self.targets.append( class_name )
            self.vectors.append( class_vectors[class_name]/class_number )
        self.vectors = torch.stack(self.vectors)
        print(self.vectors.shape)


    def compute_similarity(self, vectors):
        # self.vectors: (labels, 1024)
        # vectors (batch, 1024)
        return torch.matmul(vectors, self.vectors.T)

    def predict(self, texts):
        text_vectors = self.encode(texts)
        y_preds = self.compute_similarity(text_vectors)
        y_preds = torch.argmax(y_preds, dim=-1)
        y_preds = [ self.targets[idx] for idx in y_preds.cpu().tolist() ]
        return y_preds

    def save(self):
        pickle.dump(self.vectors, open('model/vectors.pkl', 'wb'))
        pickle.dump(self.targets, open('model/targets.pkl', 'wb'))

    @classmethod
    def load(self):
        estimator = SentimentAnalysis()
        device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
        estimator.encoder = AutoModel.from_pretrained('jina-embeddings-v3', trust_remote_code=True).to(device)
        estimator.vectors = pickle.load(open('model/vectors.pkl', 'rb')).to(device)
        estimator.targets = pickle.load(open('model/targets.pkl', 'rb'))
        return estimator


def train():
    estimator = SentimentAnalysis()
    # train_data = pickle.load(open('train.pkl', 'rb'))
    valid_data = pickle.load(open('valid.pkl', 'rb'))
    estimator.fit(valid_data)
    estimator.save()


# watch -n 1 nvidia-smi
# top
if __name__ == '__main__':
    train()
3. 效果查看
from model import SentimentAnalysis
import pickle
import torch
from torch.utils.data import DataLoader
import tqdm
from sklearn.metrics import accuracy_score


def evaluate():

    estimator = SentimentAnalysis.load()
    test_data = pickle.load(open('test.pkl', 'rb'))

    def collate_fn(batch_data):
        batch_targets, batch_reports = [], []
        for target, report in batch_data:
            batch_targets.append(target)
            batch_reports.append(report)
        return batch_targets, batch_reports

    dataloader = DataLoader(test_data, batch_size=2, collate_fn=collate_fn)
    progress = tqdm.tqdm(range(len(dataloader)), desc='Evaluate Acc: %.3f' % 0)
    y_true, y_pred = [], []
    for true_labels, batch_targets in dataloader:
        pred_labels = estimator.predict(batch_targets)
        y_true.extend(true_labels)
        y_pred.extend(pred_labels)

        # 计算准确率
        accuracy = accuracy_score(y_true, y_pred)
        progress.set_description('Evaluate Acc: %.3f' % accuracy)
        progress.update()
    progress.close()


if __name__ == '__main__':
    evaluate()
下面是 10000 条样本上跑出来的准确率:
Evaluate Acc: 0.898: 100%|██████████████████| 5000/5000 [14:29<00:00, 5.75it/s]
 冀公网安备13050302001966号